OpenAI互換のAPIで、ローカルに日本語の音声合成サーバーを立てられる「Irodori-TTS-Server」が公開されました。
リファレンス音声を渡して喋らせたり(ボイスクローン)、自分で作ったスクリプトからAPIでリクエストしたり自由にIrodori-TTSを使用できるみたいです。
今回はWindows向けに、最小構成で動かす方法をまとめました。
Irodori-TTS-Serverとは?
Irodori-TTS-Serverは、日本語音声合成のIrodori-TTSを、OpenAIのTTS APIと同じ形式で使えるようにしたサーバーです。
ツールやコードからこのサーバーのAPIを呼ぶだけで、Irodori-TTSを使えるようになりました。
そのとき設定されている標準モデルが、サーバーの初回起動時にHugging Faceから自動でダウンロードされます。
リファレンス音声によるボイスクローン、wav・mp3などの出力形式、長文の自動分割にも対応しました。
主な特徴
- OpenAI互換のエンドポイント(/v1/audio/speech)で呼べる
- リファレンス音声でボイスクローンができる
- 出力はwav・mp3・flacなどに対応
- 長文は自動で分割して合成してくれる
- 文章で声質や話し方を指定するVoice Designに対応
- v4 Smallでは合計最大120秒のリファレンス音声に対応
インストール(Windows)
ローカルへ導入する場合は、Python 3.10、Git、uvが必要です。
公式の動作要件には、mp3などの圧縮音声形式向けとしてFFmpegも入っています。
uvはPythonのパッケージ管理ツールで、入れていない場合は先に用意が必要です。


powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"準備後は、任意のパスへのリポジトリのクローンと依存関係のインストールをします。
依存は.venvに入るので自身で作る必要はないみたいです。
git clone https://github.com/Aratako/Irodori-TTS-Server.git
cd Irodori-TTS-Server
uv sync --extra cu128
copy .env.example .env
GPUが無い場合は、cu128の代わりにcpuを指定すればCPUでも動かせます(ただし生成はかなり遅くなります)。
実用的な推論速度には、CUDAまたはROCm対応GPU推奨。
uv sync --extra cpuインストールできたら、サーバーを起動します。
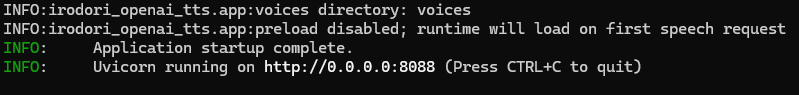
uv run --no-sync python -m irodori_openai_tts --host 0.0.0.0 --port 8088初回起動時にモデルが自動でダウンロードされるので、最初は少し時間がかかります。
こんな表示が出たら起動完了です。
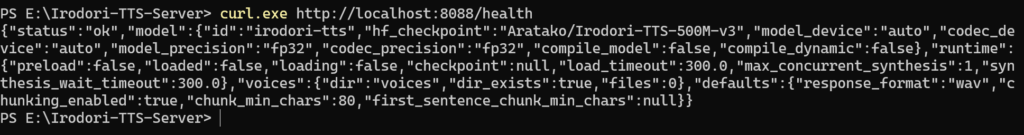
起動できたら、別のターミナルから動作確認します。
curl.exe http://localhost:8088/healthステータスが返ってくれば起動成功です。
使い方
リファレンス音声でボイスクローンする
例えばボイスクローンを生成したい場合、リファレンス音声をvoicesフォルダに置きます。
voices/
  sample.wav
あとは音声合成のエンドポイントに、喋らせたいテキストと使う声を指定してリクエストするだけです。
今回はサンプルボイスにずんだもんの音声をお借りしました。

Windowsのコマンドプロンプトはクォートの扱いが面倒なので、リクエスト内容はjsonファイルにして渡すと簡単です。
例えばbody.jsonを作って、以下の内容を書きます。
{
  "model": "irodori-tts",
  "input": "こんにちは。これはIrodori-TTSのテストです。",
  "voice": "sample",
  "response_format": "wav"
}
そのファイルを指定してリクエストします。
curl.exe http://localhost:8088/v1/audio/speech -H "Content-Type: application/json" -d '@body.json' --output speech.wav成功すると実行したパスにspeech.wavが作られ、sampleの声でテキストを読み上げた音声になりました。
公開当時のIrodori-TTS-500M-v3環境では、生成時間は2分半ほど。
以下はIrodori-TTS-500M-v3で作成したボイスクローンの音声です。
リファレンス音声なしでVoice Designを使う
Irodori-TTS-v4-Smallでは、リファレンス音声を用意せず、文章で声質や話し方を指定できます。
body.jsonのvoiceをnoneにして、irodori.captionへ声の説明を入れる構成。
{
  "model": "irodori-tts",
  "input": "本日はお越しいただき、ありがとうございます。",
  "voice": "none",
  "response_format": "wav",
  "irodori": {
    "caption": "落ち着いた低めの女性の声。丁寧で穏やかな話し方。"
  }
}
あとはボイスクローンと同じcurl.exeコマンドでbody.jsonを送信します。
長文を自動分割して読み上げる
長文の自動分割は初期設定で有効になっており、分割した音声は順番に合成されて1つの音声ファイルになります。
分割する文字数を調整したい場合は、body.jsonのirodoriに設定を書きます。
{
  "model": "irodori-tts",
  "input": "ここに長い文章を入力します。",
  "voice": "sample",
  "response_format": "wav",
  "irodori": {
    "chunking_enabled": true,
    "chunk_min_chars": 80,
    "first_sentence_chunk_min_chars": 1
  }
}
長文を逐次受信したい場合は、stream_formatにsseを指定するとチャンク単位のServer-Sent Eventsも利用可能です。
Irodori-TTS-Serverはどんなことに応用できるか
OpenAIのTTS APIと互換なので、自分で作ったツールやスクリプトからAPIで接続して音声生成が行えます。
例えばLLMに台本作って貰いそこから音声作成したり、いくつかtxtファイル用意してバッチ処理したり。
音声生成の処理を自由に組めるのがメリットだと思うので、AIエージェントとかでやりたい処理作って貰うと、生成が捗るかもしれません。
まとめ
最初に公開されたIrodori-TTSもスクリプトで実行できるしGUIもあったので、個人的にはそこまで大きな違いがわかりませんでした。
AIによると、モデルを1回ロードして常駐できるので何回もスクリプトで実行するよりは速く処理できるみたいです。
あとOpenAI互換なので、すでにOpenAIのTTSを使ってるコードなら接続先を変えるだけでも使えるとのこと。
単純に選択肢が増えたので、自分のやりたいことに合わせやすくはなってると思います。
気になった方はぜひ試してみてください。
以上Irodori-TTS-Serverの使い方を紹介しました。
参考になれば幸いです。