画像生成AI

ComfyUI

【ComfyUI】P-H3-Imageの使い方|テキストから画像生成と画像編集

ComfyUIでP-H3-Imageを使う方法を紹介します。必要なモデルの配置、テキストから画像生成と画像編集のワークフローの使い方、アップサンプラーを使うときのプロンプトの書き方、複数参照画像での編集方法を実際の生成結果と生成時間付きで解説します。
AIツール

【Fizgig】MOSS-ImageのLoRA学習のやり方|インストールからComfyUIで使うまで

Fizgigを使ってMOSS-ImageのLoRAを学習する手順を紹介します。インストールからモデルのダウンロード、キャプション付け、プリセットの選び方、LoRA Royaleでのエポック選び、ComfyUIでの使い方まで解説します。VRAM 12GBのGPUから学習できます。
ComfyUI

【ComfyUI】Fibo 2.0の使い方|Dev・Edit Turboで画像編集

Bria AIのFibo 2.0をComfyUIで使う方法を紹介します。画像編集と画像生成を1つにまとめたモデルの特徴、ライセンス、Dev版とEdit Turbo版で必要なモデルの配置、公式ワークフローの読み込み方法をまとめています。
ComfyUI

【ComfyUI】MOSS-Imageの使い方|レイアウト指定でテキストから画像生成

ComfyUIの安定版で使えるOpenMOSSの画像生成モデルMOSS-Imageの使い方を紹介。必要なモデルの配置、公式ワークフローの読み込み、テキストからの画像生成、Create Bounding Boxesで物や文字の位置を指定する方法を解説します。
ComfyUI

【ComfyUI】Flux.3 Image Kleinでテキストから画像生成・画像編集する方法

Black Forest LabsのFlux.3 Image KleinをComfyUIで使う方法を紹介します。蒸留版とBase版の公式ワークフロー4種について、テキストからの画像生成と画像編集に必要なモデルの配置と、ワークフローの読み込み手順をまとめています。
ComfyUI

【ComfyUI】BiRefNet_HRで背景除去する方法

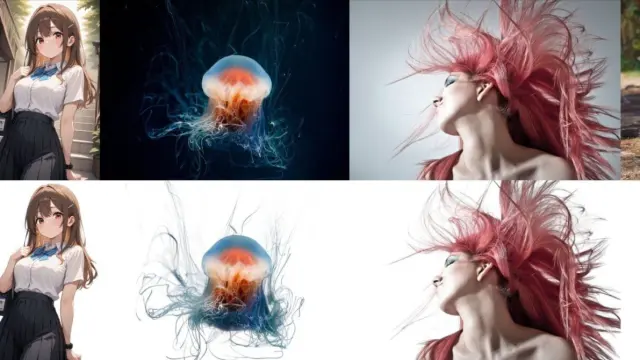
BiRefNet_HRは最大2048x2048ピクセルに対応し、髪の毛など細かい描写も高精度に背景除去できるMITライセンスのモデルです。本記事ではComfyUIでのComfyUI-RMBGやモデルの導入手順、従来のBiRefNetやRembgとの比較結果を紹介します。
ComfyUI

【ComfyUI】Qwen-Image-Layeredの使い方|1枚の画像をレイヤー分け

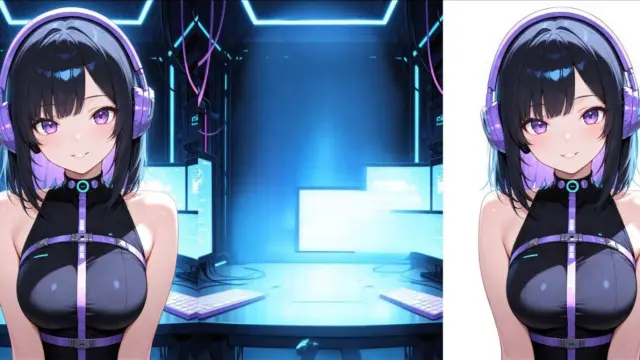
Qwen-Image-LayeredはComfyUIで1枚の画像を複数の透過レイヤーに分解できるモデルです。モデルの準備からworkflowの設定・実行までを紹介し、背景と被写体は綺麗に分かれた一方で被写体だけの画像では結果がイマイチだった検証結果もまとめています。
画像生成AI

「ImageCrop」の使い方|画像切り抜き&リサイズツール

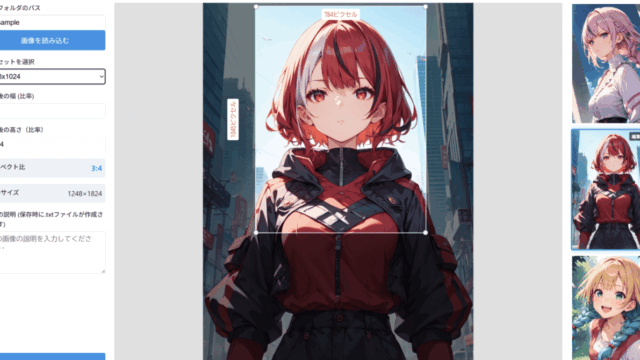
ImageCropは、フォルダ内の画像を一つずつ範囲を指定して切り抜きやリサイズができるシンプルなツールです。Pythonを使ったインストール方法、クロップとリサイズの手順、縦横比の固定を外す改造の方法を紹介します。日本語でも使えます。
画像生成AI

【Stable Diffusion】画像生成高速化技術まとめ(LCM・turbo・lightning・hyper)

画像生成の高速化技術を比較した結果、最も速度とクオリティを維持できていたのはhyper-SDでした。本記事ではLCM、Turbo、SDXL-lightning、hyper-SDについて、LoRAやマージモデルを使った設定方法と生成速度・品質の違いを解説します。
画像生成AI

【SDWebUI】「NegPiP」の使い方|ポジティブでネガティブプロンプトを使用

SDWebUIの拡張機能「NegPiP」を使うと、プロンプト内でマイナスの重みを指定して、通常のネガティブプロンプトでは消せない不要な要素を綺麗に除外できます。本記事ではインストール手順や具体的な使い方、画質への影響、ADetailerとの併用方法まで詳しく解説します。