【ComfyUI】SCAILを使う方法|動画のモーションを画像に適用

image

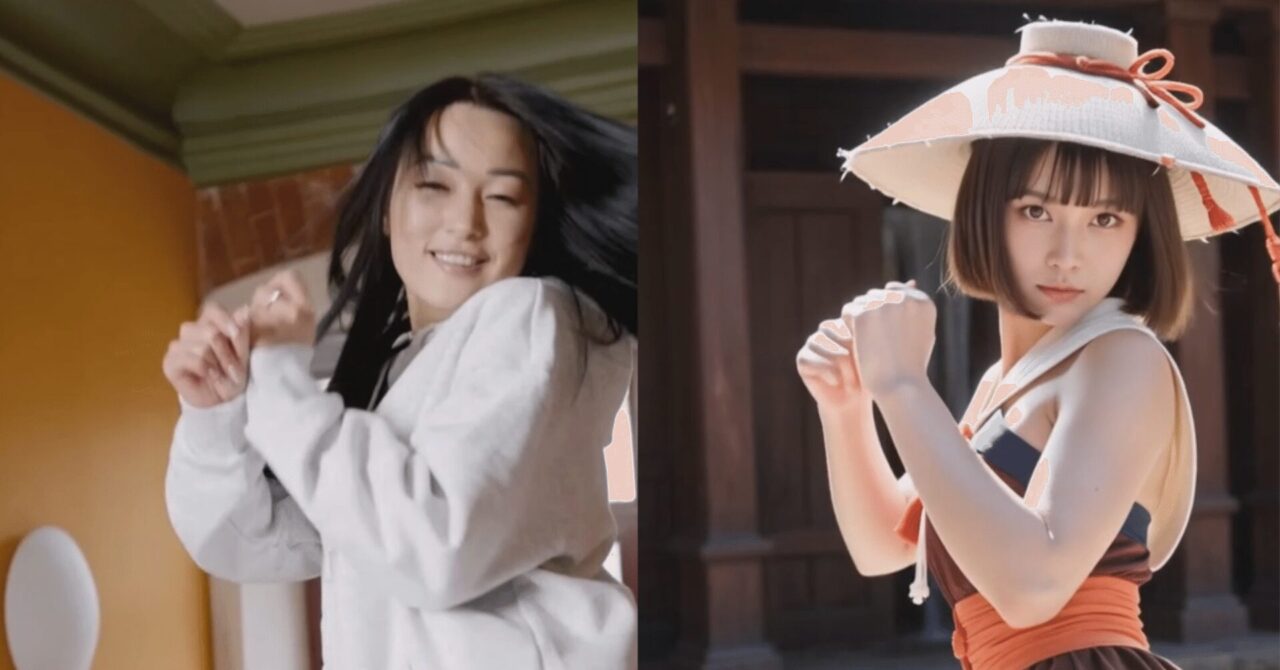
少し前にSCAILというものがリリースされました。

ComfyUIだとkijai氏のComfyUI-WanVideoWrapperで動かせます。

今回はこのSCAILをComfyUIで動かす方法について紹介します。

SCAILとは?
image

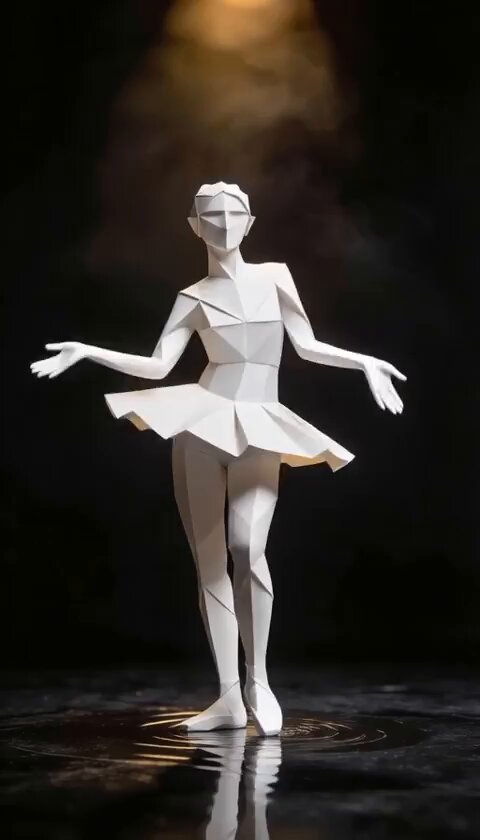
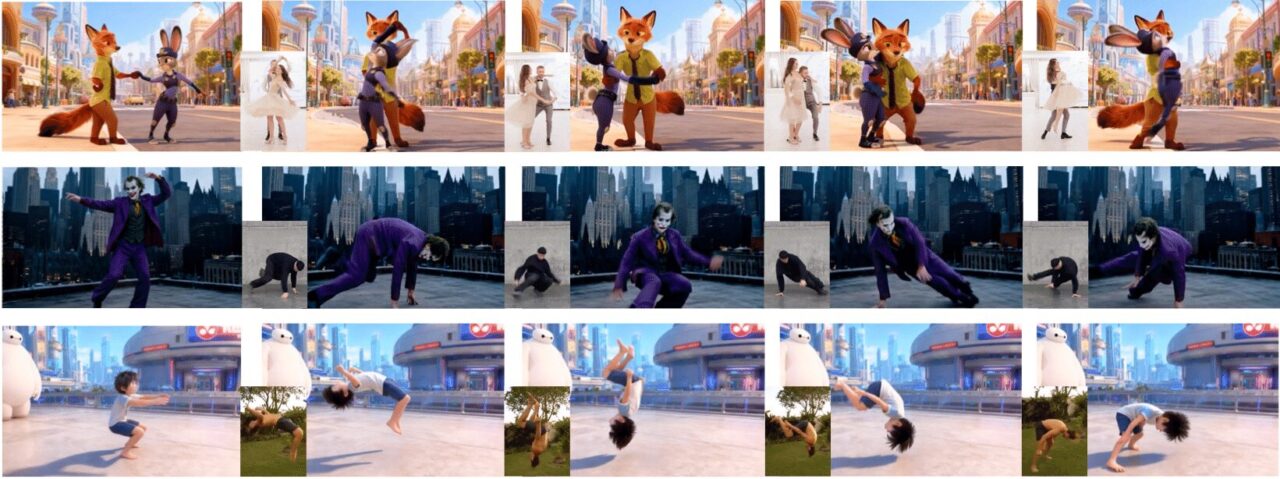
SCAILは、動画のモーションを画像のキャラクターなどに適用できるフレームワークです。

複雑な動き(バク転や回転)やスタイルの異なるキャラクターへの適用、さらに複数キャラクター間の相互作用なども高精度に再現できるとのこと。

主な特徴(AI訳)

・高度な3D一貫性とポーズ表現
3D的に一貫性のあるポーズ表現を「インコンテキスト学習(In-Context Learning)」を通じて学習。これにより、2Dキャラクターであっても3D的な空間関係を理解した自然な動きが可能。
・複雑なシナリオへの対応
マルチキャラクター: 複数の人物が絡み合うような複雑なシーンの生成が可能。
大きなモーション: 宙返り(flipping)や回転(turning)といった、従来のモデルが苦手としていた激しい動きも正確に捉える。
・驚異的な汎用性(ゼロショット能力)
学習データにほとんど含まれていない「アニメキャラ」や「手書きの落書き(Doodle Art)」、さらには「動物(クリーチャー)」に対しても、リギングなしで動きを適用できる能力。
・アイデンティティの保持
キャラクターの見た目(アイデンティティ)を崩さずに、動きの情報だけを注入する技術的な工夫がされている。

https://github.com/zai-org/SCAIL

redditのサンプル:

R@aiaicreate (@aiaicreate) on X
Stable Diffusionモデル「SCAIL」。リファレンス動画からの高精度モーション再現が特徴。キャラクターの歪みなく、ライティングの一貫性も実現する。表情転送や非人物モーションへの応用も可能。VRAM 16GB以上を推奨するモデル…

ComfyUIのインストール

ComfyUIのインストールがまだの方はこちらを参考にしてみてください。
【ComfyUI】の使い方・始め方まとめ|インストールから基本操作・カスタムノードまで
ComfyUIを始めたいけど、インストール方法がいくつかあってどれを選べばいいか迷う、という方は多いと思います。この記事では、ComfyUIの導入方法の違いと選び方、そして基本的な使い方の入口をまとめて紹介します。各トピックの詳しい手順は、…

ComfyUIでSCAILを使う方法

モデルの用意

diffusion_models

・bf16
SCAIL/Wan21-14B-SCAIL-preview_comfy_bf16.safetensors ?? Kijai/WanVideo_comfy at main
We???re on a journey to advance and democratize artificial intelligence through open source and open science.

・fp8

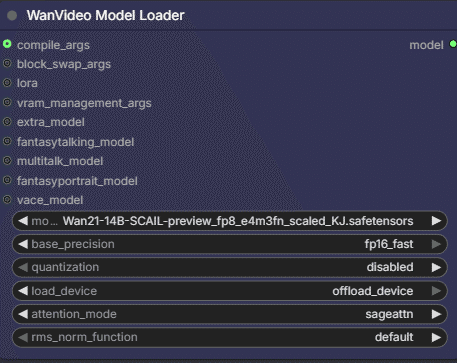
SCAIL/Wan21-14B-SCAIL-preview_fp8_e4m3fn_scaled_KJ.safetensors ?? Kijai/WanVideo_comfy_fp8_scaled at main
We???re on a journey to advance and democratize artificial intelligence through open source and open science.
ComfyUI\models\diffusion_models

YOLO・ViTPose

こちらは手動でdetectionフォルダを作成しその中に入れる必要があります。
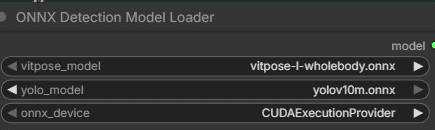
process_checkpoint/det/yolov10m.onnx ?? Wan-AI/Wan2.2-Animate-14B at main
We???re on a journey to advance and democratize artificial intelligence through open source and open science.
onnx/wholebody/vitpose-l-wholebody.onnx · JunkyByte/easy_ViTPose at main
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
ComfyUI\models\detection

LoRA

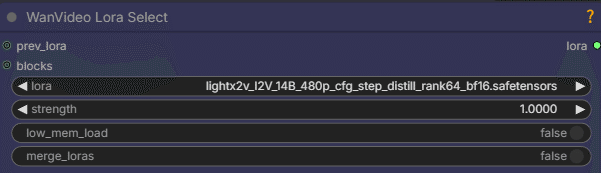
Lightx2v/lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors ?? Kijai/WanVideo_comfy at main
We???re on a journey to advance and democratize artificial intelligence through open source and open science.
ComfyUI\models\loras

Text encoder

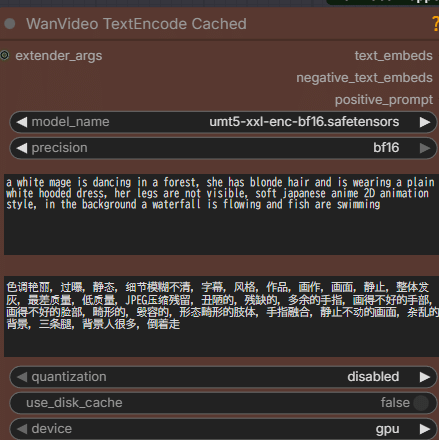
umt5-xxl-enc-bf16.safetensors ?? Kijai/WanVideo_comfy at main
We???re on a journey to advance and democratize artificial intelligence through open source and open science.
ComfyUI\models\text_encoders

CLIP Vision

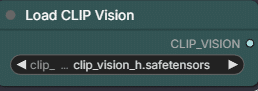
split_files/clip_vision/clip_vision_h.safetensors ?? Comfy-Org/Wan_2.1_ComfyUI_repackaged at main
We???re on a journey to advance and democratize artificial intelligence through open source and open science.
ComfyUI\models\clip_vision

VAE

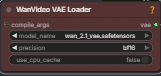
Wan2_1_VAE_bf16.safetensors ?? Kijai/WanVideo_comfy at main
We???re on a journey to advance and democratize artificial intelligence through open source and open science.
ComfyUI\models\vae

workflow

リポジトリにあるやつそのまま使ってます。

D&Dして足りないノードがあればManager→Install Missing Custom Nodesからインストールしてください。
File not found ?? kijai/ComfyUI-WanVideoWrapper
Contribute to kijai/ComfyUI-WanVideoWrapper development by creating an account on GitHub.

ノードの設定&実行

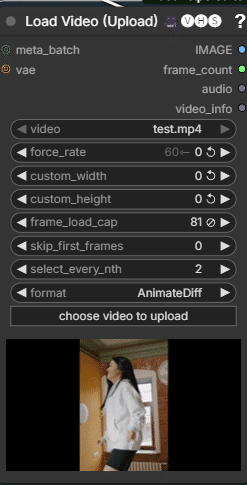
Load Video (Upload)

お借りした動画:https://www.pexels.com/ja-jp/video/4008162/
image

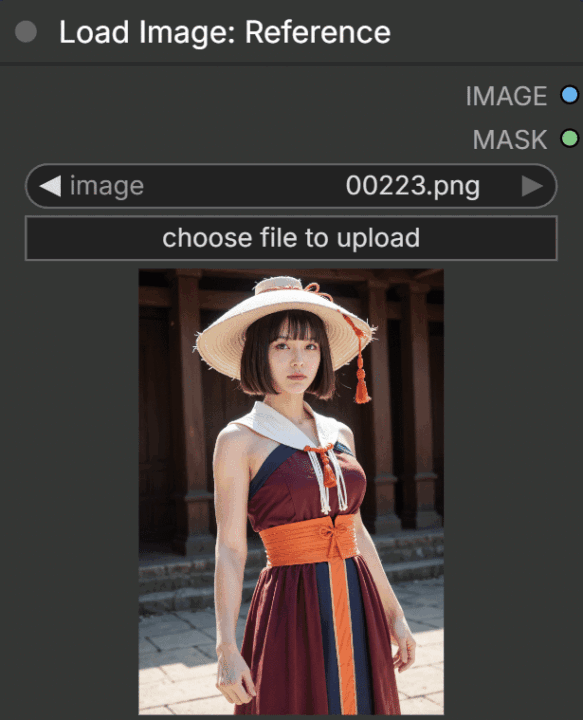
Load Image: Reference

image

ONNX Detection Model Loader

image

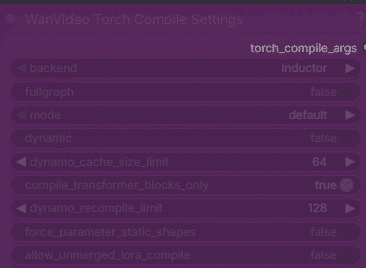
WanVideo Torch Compile Settings

SteadyDancerと同じでONだとエラーが出たため、バイパスして使ってます。
image

WanVideo Model Loader

image

WanVideo Lora Select

image

WanVideo VAE Loader

image

WanVideo TextEncode Cached

image

Load CLIP Vision

image

結果:

モデル読み込みありで2秒の動画が約5分26秒(326.68 seconds)でした。
Post
Post

まとめ

過去に似たような技術はいっぱいありましたが、ローカル生成だとダントツでクオリティ高い気がします。

顔も手も崩れてないし、ほぼ完ぺきに近いんじゃないでしょうか。

VRAM16GBでも実行できたしこの技術で2秒約5分なら許容範囲だと思います。

モーションさえ用意出来れば、いろいろ映像作品の幅を広げられるような気がしました。

個人的には従来のモデルに比べるとSCAILが一番使いやすい気がします。

興味ある方は使ってみてください。

以上ComfyUIでSCAILを使う方法について紹介しました。

参考になれば幸いです。
タイトルとURLをコピーしました