MiniMax H3を高速化できるLoRAがリリースされたので試してみました。
既存の高速化手法と異なり、モデルやノードの差し替えなど少し準備が必要です。
この記事では専用のカスタムノード導入から生成結果まで紹介します。
あとから公開されたlightx2v版のLoRAについても、記事の後半にまとめました。
MiniMax-H3-Turbo-Loraとは?
MiniMax-H3-Turbo-Loraは、MiniMax H3の生成ステップを減らすための高速化LoRAです。
最小で4ステップ生成が可能ですが、クオリティによって調整は必要とのこと。
単純計算でおよそ5倍速になり、映像と音声(32kHzステレオ)を同時に生成するMiniMax H3の性質はそのままのようです。
ただし作者さんが「早期のプロトタイプで学習途中のチェックポイント」と明記していて、品質は完成品ではありません。
本家のLoRAは非pruned版のモデル向けですが、有志の方がpruned版のモデル向けに変換したLoRAも配布されています。
主な特徴
- MiniMax H3の生成を約20ステップから4ステップに減らす高速化LoRA
- ベースは Comfy-Org/MiniMax-H3
- 映像と音声(32kHzステレオ)を同時に生成
- 重みはbf16で1ファイルおよそ780MB
- 学習途中の早期チェックポイントで品質は発展途上
- 非pruned版で使う場合は専用のカスタムノード ComfyUI-MiniMax-H3-Turbo が必要
- ライセンスはApache-2.0

必要なもの
まずComfyUIが必要です。
インストールがまだの方はこちらを参考にしてみてください。

MiniMax H3についてはMiniMax H3の使い方で紹介しています。
ベースモデルとLoRAの組み合わせ
pruned版・非pruned版で使用するLoRAや設定が異なります。
今回非pruned版はminimax_h3_fl2va_int8_convrot、pruned版はminimax_h3_fl2va_pruned_int8_convrotで試しました。
追記:Readmeや追加のモデルが更新されていて、v4_step600_emaが推奨されています。
もしそちらで試したい方はv4_step600_emaをダウンロードしてください。
| 非pruned版 | pruned版 | 配置先 | |
|---|---|---|---|
| ベースモデル | minimax_h3_fl2va_int8_convrot.safetensors | minimax_h3_fl2va_pruned_int8_convrot.safetensors | ComfyUI\models\diffusion_models |
| LoRA | minimax_h3_turbo_4step_ckpt500.safetensors | minimax_h3_turbo_4step_ckpt500_pruned_comfyui.safetensors | ComfyUI\models\loras |
| LoRA(v4_step600_ema) | minimax_h3_turbo_v4_step600_ema.safetensors | minimax_h3_turbo_v4_step600_ema_pruned_comfyui.safetensors | ComfyUI\models\loras |
非pruned版の使い方
カスタムノードのインストール
専用のカスタムノード ComfyUI-MiniMax-H3-Turbo が必要です。
ComfyUI-Managerからインストールする場合は、Custom Nodes Managerで「MiniMax-H3 Turbo」を検索してください。

手動で入れる場合は、custom_nodes でクローンします。
cd ComfyUI\custom_nodes
git clone https://github.com/Larryvrh/ComfyUI-MiniMax-H3-Turbo
入れ終わったらComfyUIを再起動します。
非pruned版のワークフロー設定
公式のMiniMax H3(i2v)のワークフローを土台にして、Image to Video (MiniMax H3)のサブグラフ内、または展開してから2か所だけ変更します。
MiniMax-H3 Turbo LoRA or 普通のLoad LoRA

MiniMax-H3 Turbo LoRAを追加して、Load Diffusion Modelとサンプラーの間に挟み、Basic Guider・BasicSchedulerに繋いでください。
MiniMax-H3 Turbo LoRAでダウンロードしたLoRAを選びます。
MiniMax-H3 Turbo Sampler (4-step)
SamplerCustomAdvancedに繋がってるKSamplerSelectを外して、MiniMax-H3 Turbo Sampler (4-step)に差し替えます。

パラメータ
あとはBasicSchedulerで、Schedulerをsimple、stepsを4にします。

| 項目 | 値 |
|---|---|
| steps(BasicScheduler) | 4(4以上なら何ステップでも有効。シャープさ重視なら6〜8) |
| scheduler | simple 固定 |
| 幅・高さ | 32の倍数。短辺は768あたりが目安 |
| フレーム数 | 24fpsで、およそ124〜362(5〜15秒程度)が検証済みの範囲 |
非pruned版の実行結果
VRAM16GBで10秒(576×736)の動画を生成してstepごとにまとめました。
| ステップ数 | 生成時間 |
|---|---|
| 20step | 1054seconds(約17分34秒) |
| 4step | 269.43seconds(約4分29秒) |
| 5step | 322.44seconds(約5分22秒) |
| 6step | 376.24seconds(約6分16秒) |
| 7step | 433.69seconds(約7分14秒) |
| 8step | 484.80seconds(約8分5秒) |
| 8step(Sage Attention+Patch Sol-Attn) | 282.67seconds(約4分43秒) |
pruned版の使い方
pruned版の方は作者の方がワークフローを上げてくれているので、こちらを使用します。
fl_minimax_h3_turbo_lora_example_workflow.json
pruned版のワークフロー設定
基本は画像とモデルをセットして、あとは次の3つを調整するだけです。
- BasicSchedulerのstep
- Scale Image to Total Pixels・Resolution Selectorのmegapixels
- Float (duration)
デフォルトでmegapixelsが1以上、Float (duration)が18になってるので、スペックに合わせて調整してください。
任意でPatch Sol-Attnなどの高速化ノードも併用できます。

pruned版の実行結果
こっちはアスペクト比とFloat (duration)を変えるの忘れてて、18秒(480×864)で生成した結果です。
| ステップ数 | 生成時間 |
|---|---|
| 20step | 2891seconds(約48分11秒) |
| 4step | 681seconds(約11分21秒) |
| 5step | 801seconds(約13分21秒) |
| 6step | 936seconds(約15分36秒) |
| 7step | 1068seconds(約17分48秒) |
| 8step | 1215seconds(約20分15秒) |
| 8step(Optimisations併用) | 623seconds(約10分23秒) |
lightx2v版の4step LoRA
その後、lightx2vからもMiniMax H3を4ステップ化するLoRAが公開されました。
KijaiさんがComfyUI用に変換した重みをHugging Faceで配布しています。
配布されているのは次の2ファイルですが、SNS見てるとminimax_h3_fl2v_lightx2v_turbo_4step_v0.1_comfy.safetensorsの方を使ってる方が多いのでこの記事でもそっちを試します。
| ファイル | サイズ | 配置先 |
|---|---|---|
| minimax_h3_fl2v_lightx2v_turbo_4step_v0.1_comfy.safetensors | 1.96GB | ComfyUI\models\loras |
| minimax_h3_fl2v_lightx2v_turbo_4step_v0.1_comfy_resized_avg_rank_21_bf16.safetensors | 315MB | ComfyUI\models\loras |
lightx2v版のワークフロー設定
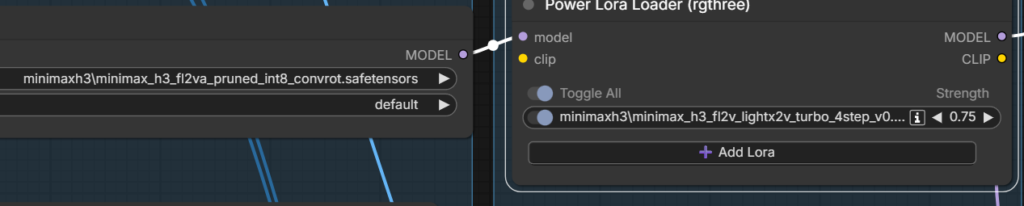
公式のi2vワークフローに組み込む場合は、まずLoRA Load用のノードを追加してモデルのあとに繋ぎます。
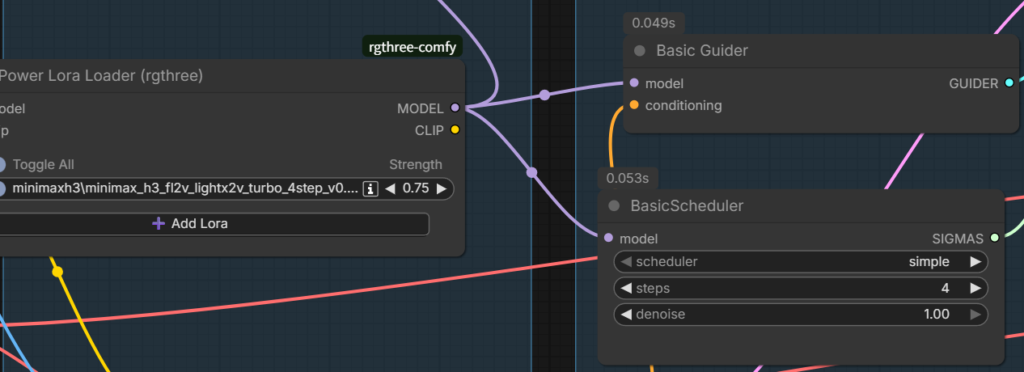
あとはLoRAからBasic Guider・BasicSchedulerに繋ぎます。
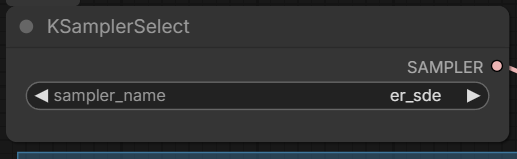
KSamplerSelectをer_sde または sa_solverにしてください。
lightx2v版のパラメータ
配布ページに書かれている設定は次のとおりです。
| 項目 | 値 |
|---|---|
| steps | 4 |
| LoRA strength | 0.75 |
| サンプラー | er_sde または sa_solver |
lightx2v版の実行結果
| ステップ数 | 生成時間 |
|---|---|
| 4step | 267.95seconds(約4分27秒) |
まとめ
非pruned・pruned版は4stepだとチラつきが発生するので、最低6stepは必要かなという印象でした。
ただ4stepで崩れず生成できている人もいたので、なんか設定間違えてるかもしれません。
あと6stepやるなら8step+高速化ノードの方が処理速度も速くクオリティも安定しているので、8step+高速化ノードが無難な気もします。
20stepと8step+高速化ノードで比較すると1054→282.67秒で約3.7倍、2891→623秒で約4.6倍になっており、長い動画ほど恩恵がありました。
10秒の動画だとPatch Sol-Attn+EasyCache+Sage Attentionよりも高速化できています。
- Patch Sol-Attn+EasyCache+Sage Attention:363seconds(約6分3秒)
- 8step(Sage Attention+Patch Sol-Attn):282.67seconds(約4分43秒)
lightx2v版はカスタムノードもなく4stepだけで比較的綺麗に生成できました。
若干劣化を感じる部分はあるものの、処理速度は非pruned・pruned版とほぼ変わらず、かつカスタムノードを入れなくていいので設定は簡単だと思います。
使うLoRAによっては少しワークフローの設定が面倒だったり、若干クオリティが気になる部分もありますが、今のところ速さだけならLoRA+高速化ノードが一番良さそうな結果でした。
以上MiniMax-H3-Turbo-Lora(4step)の使い方を紹介しました。
参考になれば幸いです。