ComfyUIの公式テンプレートに、FastVideo FastH3で動画と音声を一緒に生成するワークフローが追加されました。
この記事ではFastVideo FastH3の基本的な使い方について紹介します。
FastVideo FastH3とは?
FastVideo FastH3は、MiniMax H3をDMD2で蒸留した8ステップ版のチェックポイントです。
元のモデル(LoRAなし)は20stepで生成しますが、FastH3は8STEPで生成可能。
MiniMax H3の蒸留モデルなのでプロンプトの書き方は同じで、音声・動画・効果音なども一緒に生成できます。
主な特徴
- 8ステップのサンプリングで映像と音声を同時に生成する
- セリフ・効果音・音楽が映像に同期した状態で出力される
- テキストからの生成(t2va)と、最初/最後のフレームを与える生成(fl2va)に対応
- 複数の参照画像を使うRef2VAは蒸留されておらず、ベースのMiniMax H3が必要
ライセンス
配布ページに記載されているライセンスは、MiniMax H3 Community License Agreementです。
条文はMiniMaxAI/MiniMax-H3のLICENSEで確認できます。
ComfyUIでFastVideo FastH3を使う方法
ComfyUIのインストール
ComfyUIのインストールがまだの方はこちらの記事を参考にしてみてください。
またComfyUIはv0.36.0から対応しているので、それ以前のバージョンをお使いの方は更新が必要です。
必要なモデルと配置先
FastVideo FastH3は、4つのファイルが必要です。
diffusion model以外はMiniMax H3と同じなので、既に持ってるなら入れなくてOKです。
| 種類 | ファイル名 | 配置先 |
|---|---|---|
| diffusion model | fastvideo_fasth3_8step_v2_pruned_int8_convrot.safetensors | ComfyUI/models/diffusion_models |
| text encoder | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | ComfyUI/models/text_encoders |
| VAE(映像) | minimax_h3_video_vae_fp16.safetensors | ComfyUI/models/vae |
| VAE(音声) | minimax_h3_audio_vae_fp32.safetensors | ComfyUI/models/vae |
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── fastvideo_fasth3_8step_v2_pruned_int8_convrot.safetensors
│   ├── text_encoders/
│   │   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
│   └── vae/
│       ├── minimax_h3_video_vae_fp16.safetensors
│       └── minimax_h3_audio_vae_fp32.safetensors

ワークフローの読み込み
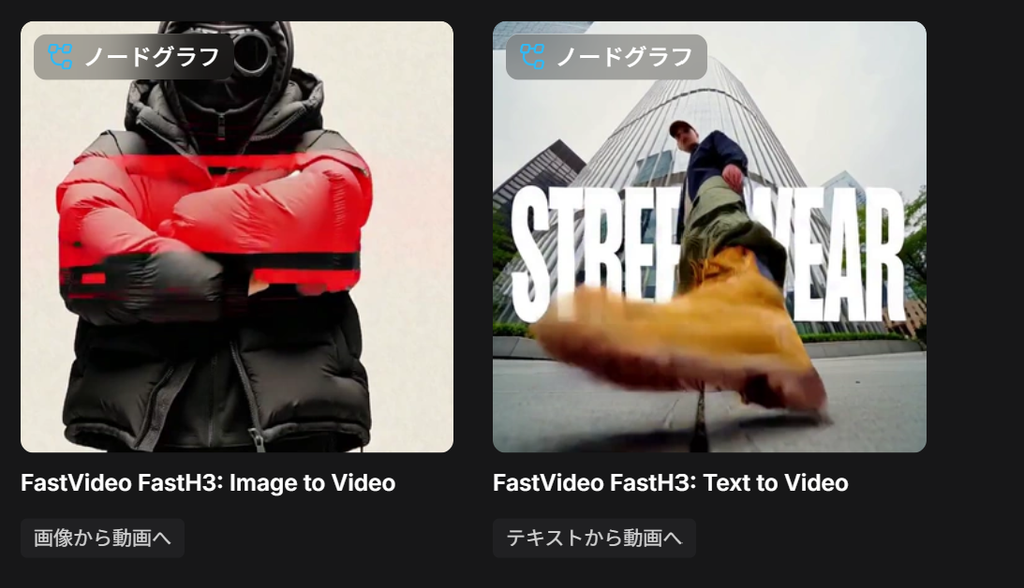
FastVideo FastH3のテンプレートは、画像から動かすvideo_fastvideo_fasth3_i2v.jsonと、テキストだけで作るvideo_fastvideo_fasth3_t2v.jsonの2種類です。
ComfyUIの左上にあるメニュー→テンプレートを参照からも読み込めます。
FastVideo FastH3の設定と生成
Text to Video
Text to Videoはモデルセットして生成したい動画の内容を書くだけです。
Resolution Selectorで解像度やアスペクト比の設定ができます。
プロンプトの書き方はMiniMax H3と同じなので、こちらの記事を参考にしてみてください。
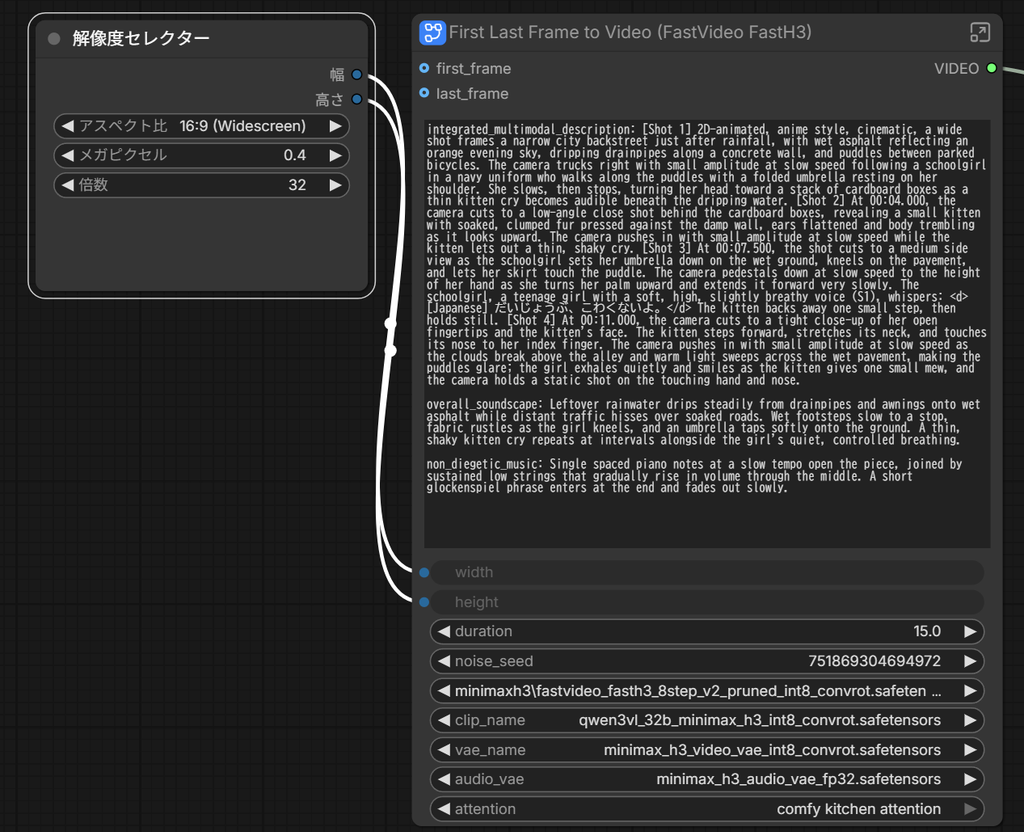
あとvideo vaeとTEはint8のものを使っています。
15秒の動画(16:9・0.4MP)で5分 58秒でした。
(RTX4060Ti VRAM16GB/RAM64GB)
Image to Video
Image to Videoはload imageがあるだけでText to Videoのworkflowとほぼ同じです。
first_frameだけなら通常のI2V、last_frameだけならL2V、両方セットすればFL2Vとして生成できます。
first_frameだけセットして6分42秒でした。
minimax_h3_fl2va_int8_convrotとkitchen attention、8step LoRAなど条件同じでやると6分45秒とほぼ同じでした。
この動画しか比較してないですが、FastH3の方が音とかは綺麗な気がします。
まとめ
同条件だと処理速度がそこまで変わらず、LoRAの用意も必要ないのでFastH3の方が始めやすいように感じました。
品質・音質については私とは逆に悪いというレビューもあったので、生成する動画や内容によるのかもしれません。
個人的には音はFastH3の方が良く感じました。
他にも速さだけなら4step LoRAとかその他高速化技術もあるので、自分の生成したい動画に合わせて選ぶのが無難な気がします。
以上FastVideo FastH3の使い方を紹介しました。
参考になれば幸いです。