Fizgigは、画像・動画・音楽モデルのLoRA学習と調整を1つのアプリで行えるツールです。
AI Toolkitと似たような操作で、プリセットを選ぶだけで簡単に学習ができます。
この記事ではFizgigのインストールから、MOSS-ImageのLoRA学習、ComfyUIで生成するところまで紹介します。
Windowsの方向けです。
Fizgigとは?
Fizgigは、Peter Neill氏(shootthesound)が開発しているLoRA学習ツールです。
LoRAやLoKRの学習に加えて、モデル本体のファインチューニングにも対応しています。
専用ウィンドウとブラウザのどちらでも同じ画面で操作でき、RunPodなどで借りたGPUでも動かせる仕組みです。
またMOSS-Image以外にもさまざまなモデルの学習に対応しています。
主な特徴
- Flux 2 Klein 9B、Flux 3 Image Klein、Krea 2、MiniMax H3、Qwen Image 2.1、MOSS-Image、Z-Image Turbo、SDXL、Anima、ACE-Step 1.5 XLに対応
- 画像の下準備やAIによるキャプション付けもアプリ内で行える
- 全エポックを同じシードで並べて比べるLoRA Royaleを搭載
- LoRAをブロック単位で調整するStudioや、ランクを下げるExtractも使える
- 出力はComfyUIでそのまま使える.safetensors形式
ライセンス
FizgigのライセンスはApache License 2.0です。
学習に使うモデルの重みはこのライセンスの対象外で、各モデルの配布元の条件に従います。
MOSS-Imageの重みもApache-2.0で公開されているため、商用利用も可能です。
必要なスペック・動作環境
Fizgigで学習するには、以下の環境が必要です。
- GPU:NVIDIA RTX 30/40/50シリーズ、またはROCm対応のAMD Radeon
- NVIDIAドライバー:Windowsは555以降、Linuxは550以降
- OS:Windows 10/11、Linux
- Python:3.10〜3.13
- Git
- システムメモリ:32GB推奨
- ストレージ:仮想環境に約10GB、モデルファイルに約40GB
MOSS-ImageのLoRA学習は、VRAM 12GBから行えるそうです。
PythonとGitは、事前にそれぞれの公式サイトからインストールしておいてください。
Fizgigのインストール
まずFizgigを任意のパスにクローンします。
git clone https://github.com/shootthesound/Fizgig.gitFizgigというフォルダができるので、中にあるinstall_fizgig.batをダブルクリックしてください。
必要なライブラリなどがインストールされるので、終わるまで待機して、終わったらターミナル画面は消して大丈夫です。
起動方法は2つあります。
開く場所が違うだけで操作はどちらも同じです。
Launch Fizgig.bat:専用ウィンドウで開くLaunch Fizgig in browser.bat:ブラウザで開く
Fizgigを更新したいときはupdate_fizgig.batを実行します。
MOSS-Imageモデルの指定 or ダウンロード
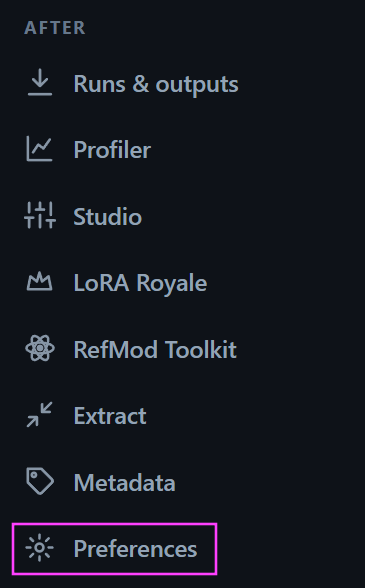
Fizgigを起動したら、左側のメニューにあるPreferencesタブを開きます。
Model Paths (MOSS-Image)を開くとこんな画面になるので、もしモデルを既に持っている方は、Chooseからそれぞれ対応するモデルを指定してください。
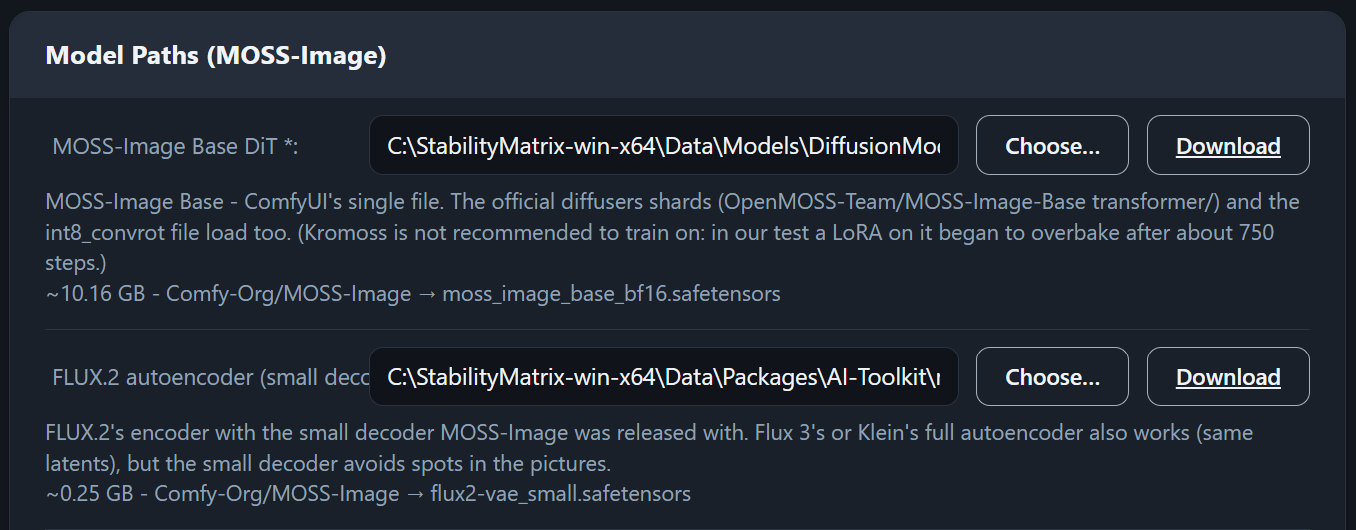
モデルを持ってない場合は、下にある「Download models for me」を押すと、必要なファイルのダウンロードからパスの設定まで行ってくれます。
ダウンロードされるファイルは以下の通りです。
- 拡散モデル(学習用のBase):moss_image_base_bf16.safetensors・約10.2GB
- 拡散モデル(プレビュー用のSFT):moss_image_sft_int8_convrot.safetensors・約5.4GB
- テキストエンコーダー:qwen3.5_9b_bf16.safetensors・約19.3GB
- VAE:flux2-vae_small.safetensors・約0.25GB
Fizgigは学習をBaseで行い、プレビューや実際の生成にはSFTを使うようです。
MOSS-ImageでLoRAを学習する
学習は、画面の番号付きタブを上から順に進めます。
①Start:学習画像のフォルダを指定
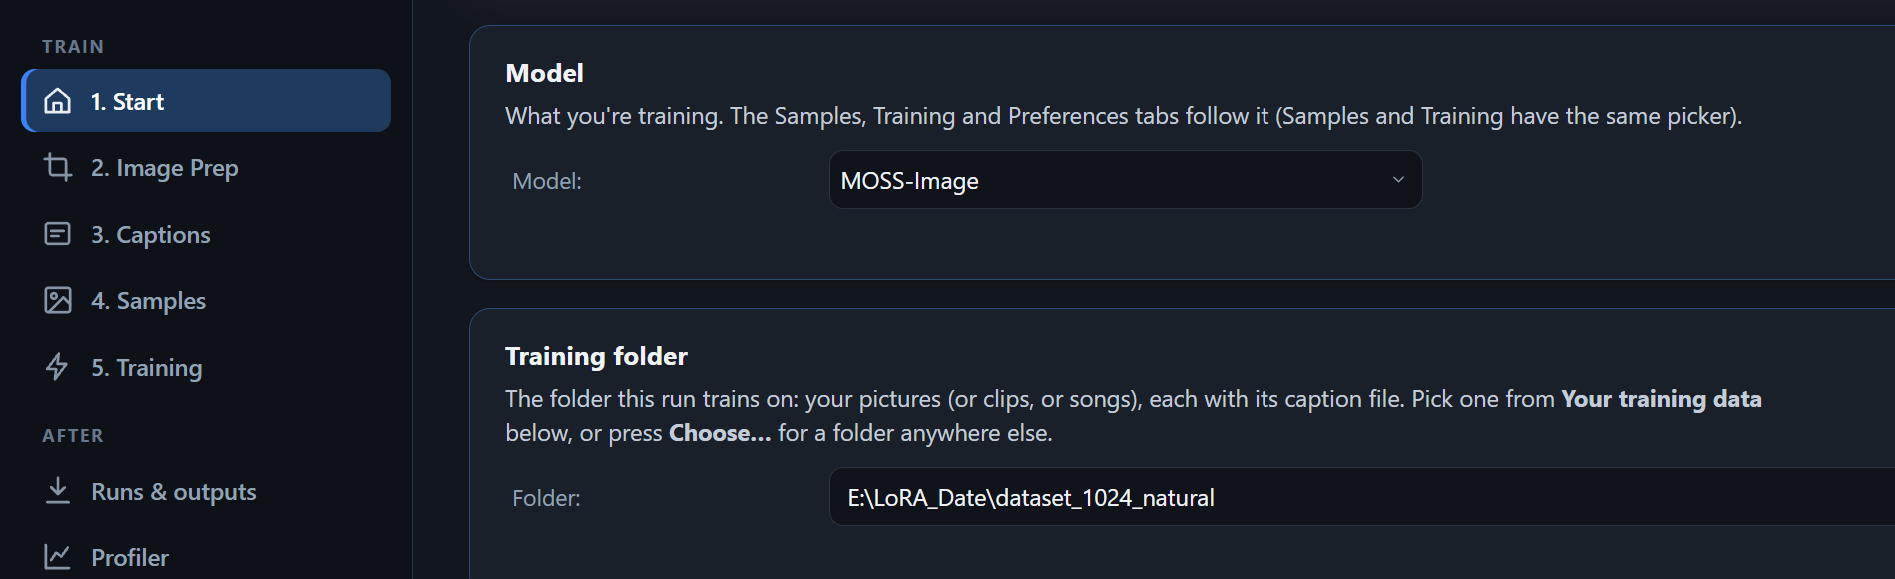
Startタブで、ModelをMOSS-Image、Training Folderに学習に使う画像を入れたフォルダを指定します。
②Image Prep:画像の下準備(任意)
Image Prepタブは、画像のリサイズや顔部分の切り抜き、見た目の合わない画像の除外が行えます。
ここは任意なので飛ばしても問題ありません。
マスク学習を使う場合は、ここでマスクも作成してください。
公式READMEによると、MOSS-Imageではマスク学習が特に効果的なようです。
③Captions:キャプションを付ける
事前に画像フォルダにファイル名と同じキャプションデータがある場合は、ここは飛ばせます。
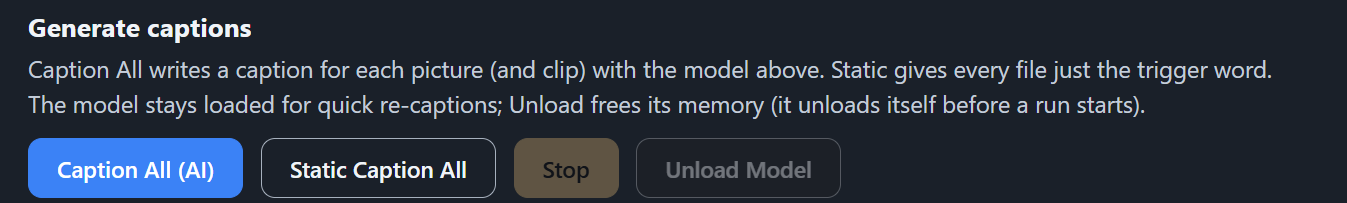
画像のみ、またはキャプションを作り直したい場合は、Qwen3-VL-4BかFlorence-2でキャプションデータを作れます。
Qwen3-VL-4Bを使いたい方は、モデルをDL後、Preferencesタブ→Model Paths (Krea 2)→Qwen3-VL-4B text encoderで、モデルのパスを指定してください。
Captionsタブを開いて、トリガーワードやキャプション付けに使うモデルなどを指定します。
- Trigger Word:LoRAを呼び出すときに使うキーワード
- Model:キャプション付けに使うモデル。Florence-2は選択したものが自動でダウンロードされます。
- Task:キャプションに画像の詳細をどれくらい入れるかを指定するもの。MOSS-Imageは<MORE_DETAILED_CAPTION>にした方がいいそうです。
- Overwrite existing captions:同じファイル名のキャプションがあったら上書きするかどうか
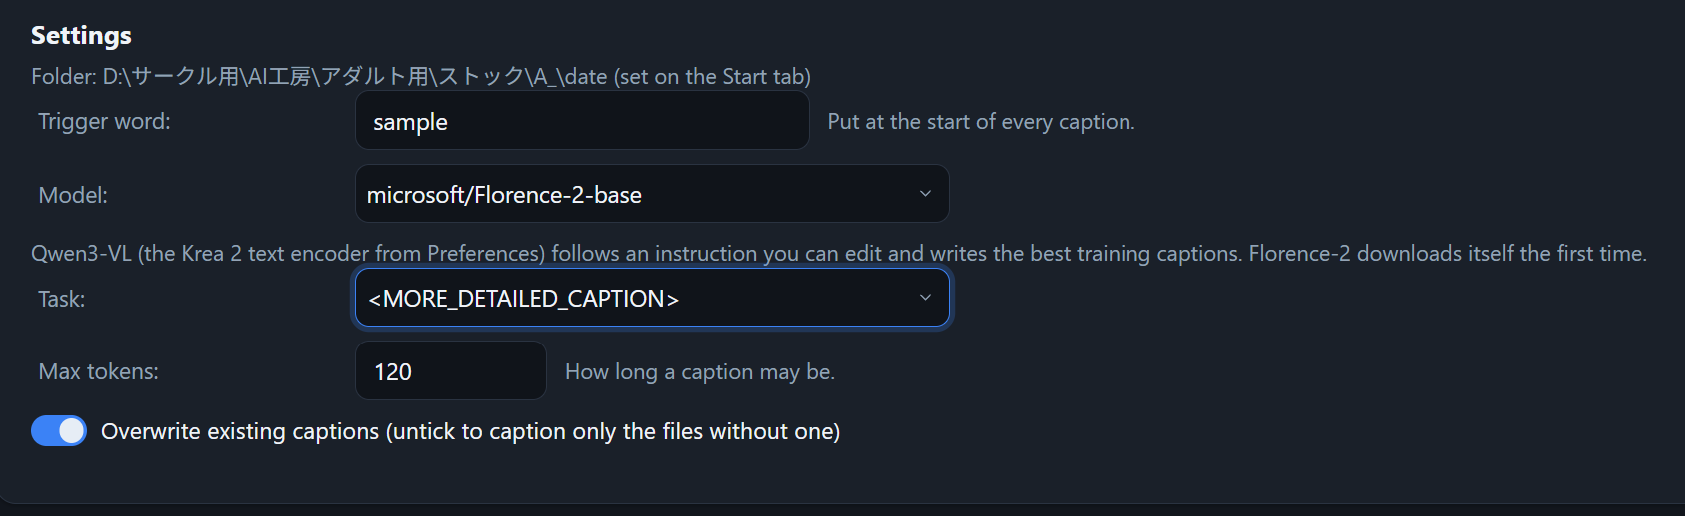
設定後、Caption All (AI)を押すとキャプション付けが始まります。
④Samples:プレビュー用のプロンプトを決める
Samplesタブでは、学習中に生成するプレビュー画像のプロンプトを設定します。
プレビューが不要の場合は、Make previews while trainingをオフにしてください。
なお、後述するLoRA Royaleというタブだと、学習後、エポックごとに保存した全てのLoRAで画像生成し、比較することが可能です。
生成用のSFTモデルをメモリに置いたままらしいので、プレビューでもモデル切り替えによる遅延は少ないと思いますが、LoRA Royaleで後から比較した方が多少効率は良いかもしれません。
まずModelをMOSS-Imageにします。

Promptsにプレビューで生成するためのプロンプトを入れます。
公式READMEによると、学習画像にない構図や場所を1つのプロンプトに入れておくのがコツだそうです。
Baseモデルで確認したい場合は、「Use the SFT model for samples」のチェックを外してください。
⑤Training:モデルとプリセットを選んで学習開始
Trainingタブで、モデルにMOSS-Imageを選びます。
MOSS-Image用のプリセットは以下の通りです。
| プリセット | rank | 学習率 | エポック数 | 学習解像度 |
|---|---|---|---|---|
| Fast | 16 | 1e-4 | 70 | 0.25MP |
| Standard | 32 | 1e-4 | 70 | 1MP |
| Style | 16 | 5e-5 | 50 | 1MP |
| Slider | 8 | 2e-4 | 20 | 1MP |
一応RTX4060Ti(VRAM16GB/RAM64GB)でもStandardの学習はできました。
なので一般的なLoRA学習であれば基本はStandardで、スペックに不安があるならFast、その他用途に合わせて、StyleやSliderを選ぶのがいいと思います。
任意でLoRA名や出力先も指定できます。
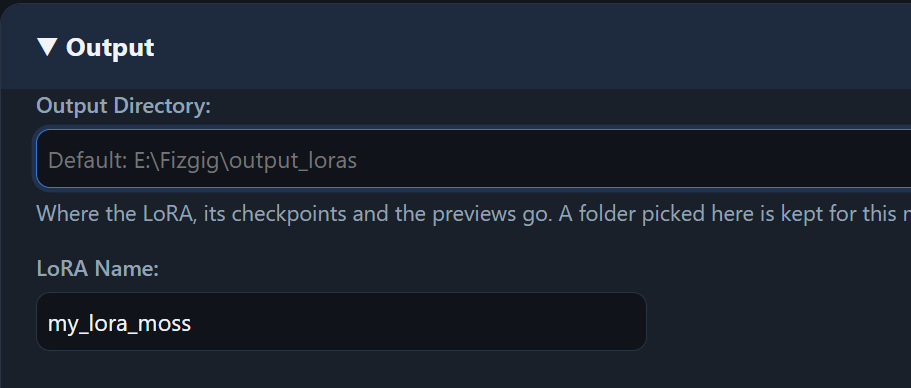
設定ができたら下の方にある「Start Training」を押せば学習が開始されます。
RTX4060Ti(VRAM16GB/RAM64GB)でやって以下の通りでした。
- プリセット:Standard
- 学習条件:画像30枚・70エポック(1エポック30ステップ)・rank 32・解像度992×992
- 全体の時間:約4時間24分
- 学習のみ:2100ステップ2時間49分24秒(1ステップあたり約4.84秒)
- ※差はプレビュー生成があったため
- VRAM使用量:ピークが9.4GB
学習したLoRAを選ぶ
LoRAはエポックごとに保存され、初期設定ではFizgigフォルダ内のoutput_lorasに出力されます。
Samplesでプレビュー生成している場合は、Samplesタブでエポックごとに生成された画像を確認できます。
プレビュー生成してないけど後から画像生成して確認したいという場合は、LoRA Royaleタブで一括生成が行えます。
LoRA Royaleタブを開いて、モデルをMOSS-Imageにし、Checkpoint folderやプロンプトなどを指定してください。
Checkpoint folderはエポックごとに保存されたLoRAがあるフォルダ、Save toは生成結果を保存するフォルダです。
output_lorasには他のモデルで学習した結果も出力されるため、MOSS-ImageのLoRAだけサブディレクトリなどに移動してから指定した方が混ざらずに済みます。
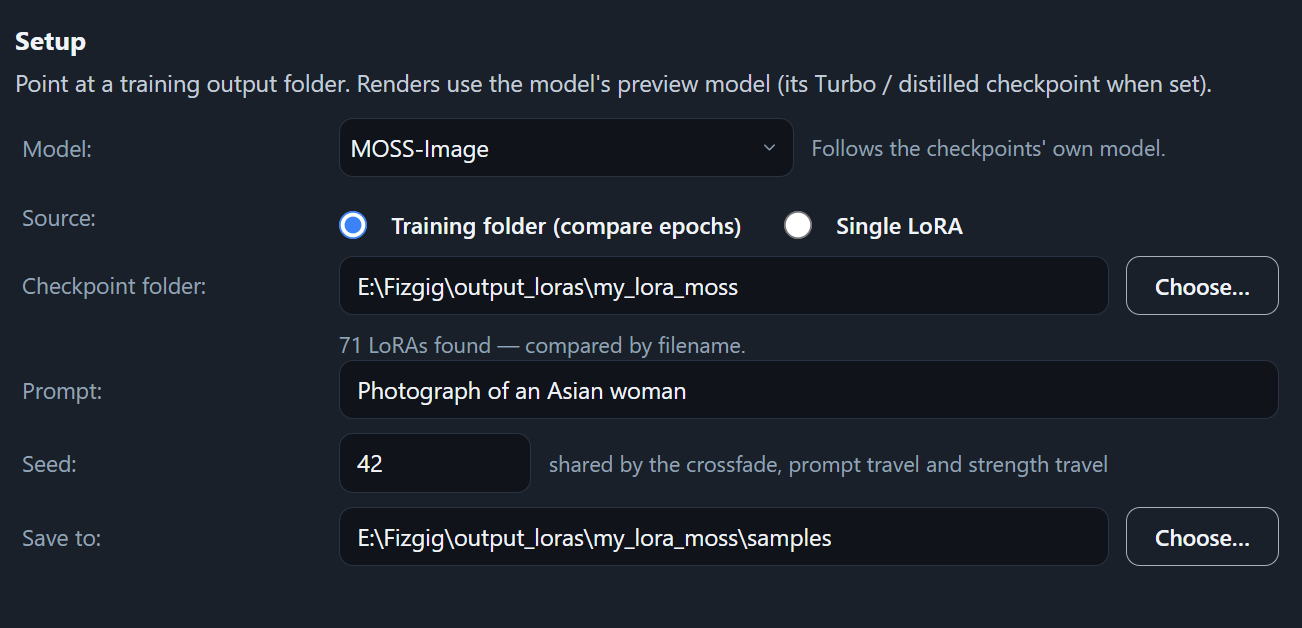
設定後、Epochsタブで画像サイズとMax rendersを指定して、Render epochsをクリックすれば生成が開始されます。
Max rendersは最初と最後のエポックを必ず入れて、その間を等間隔に間引いて選び生成するものです。
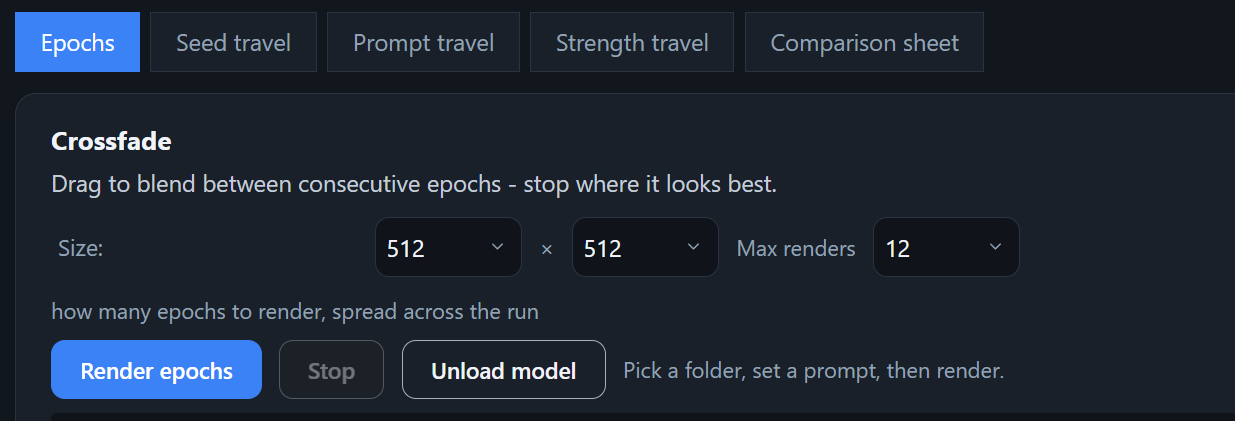
これで結果を比較して、使用したいLoRAを選んでみてください。
学習したLoRAをComfyUIで使う
上で選んだ使いたいLoRAをComfyUI\models\lorasに移動します。
MOSS-Imageは別途使い方について書いた記事があるので、そちらを参考にしてください。

workflowはSFTのものを使います。
取り込んだらText to Image (MOSS-Image)のサブグラフ内に入り、Load Diffusion Modelの後にLoad LoRAを繋いでください。
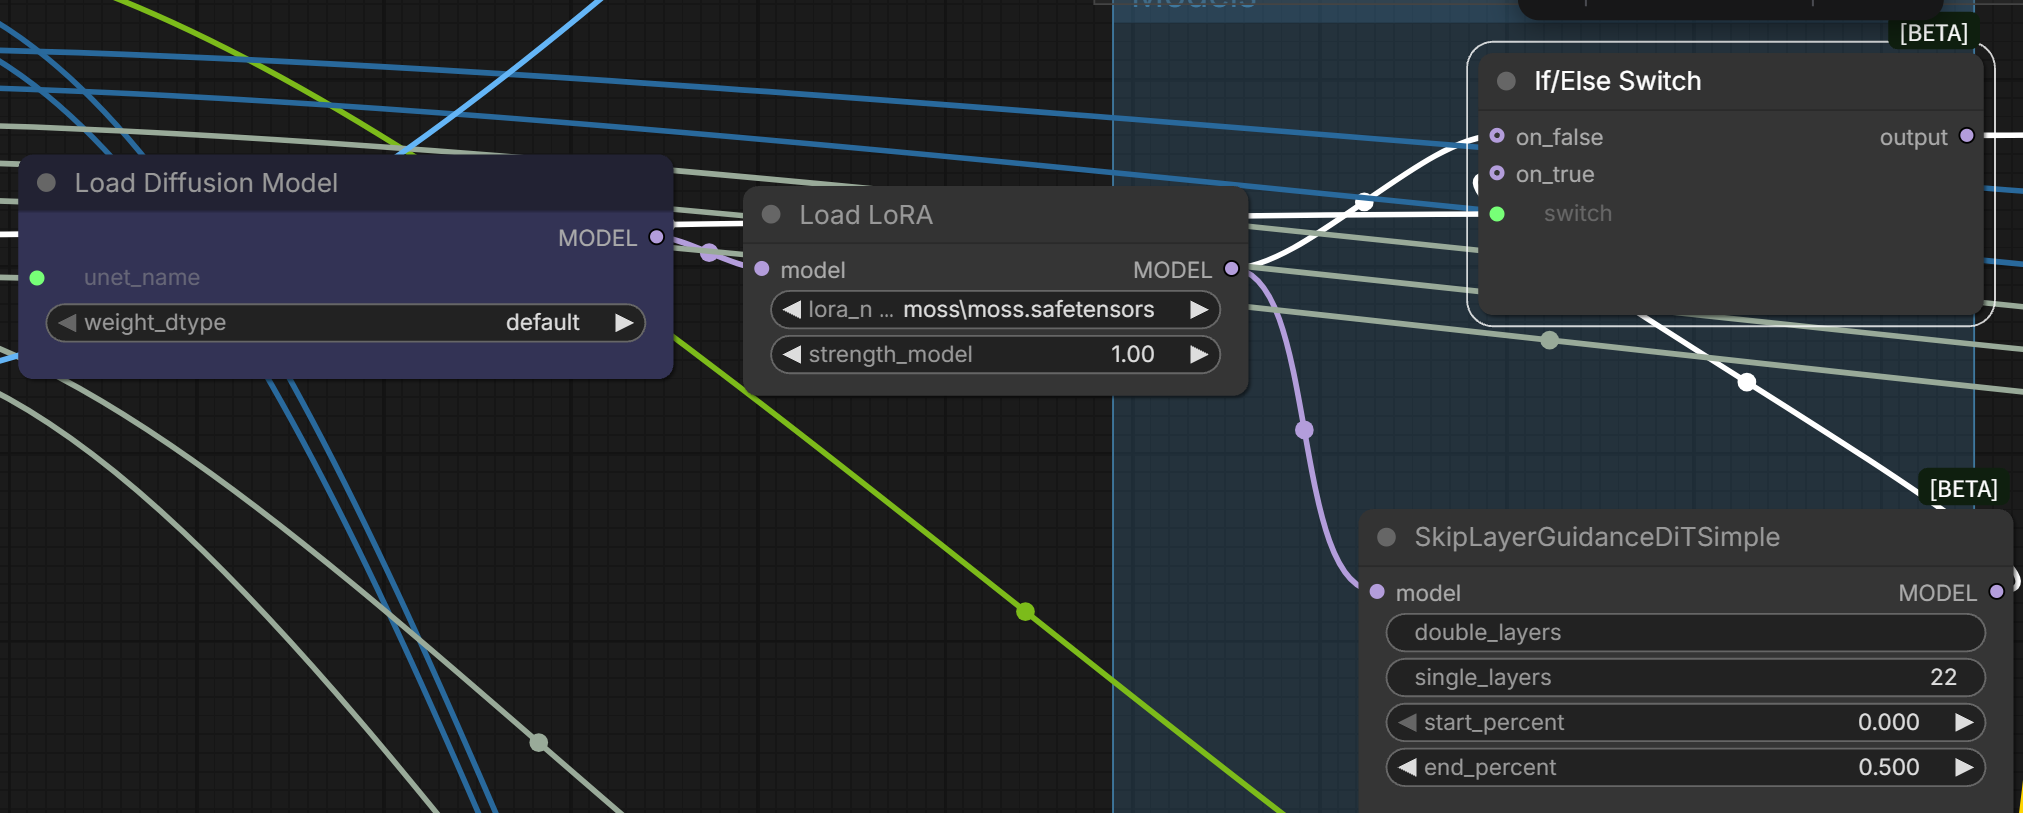
Fizgigだと以下が推奨設定になっています。
| ノード | 設定 |
|---|---|
| KSampler | サンプラーres_multistep・スケジューラーsimple・30ステップ・CFG 4 |
| SkipLayerGuidanceDiTSimple | 対象レイヤー22・開始0・終了0.5 |
| ネガティブプロンプト | worst quality, bad anatomy, watermark, jpeg artifact |
設定がデフォルトのままなら、ComfyUI側で変えるのはサンプラー、ステップ数、SLGのオンくらいです。
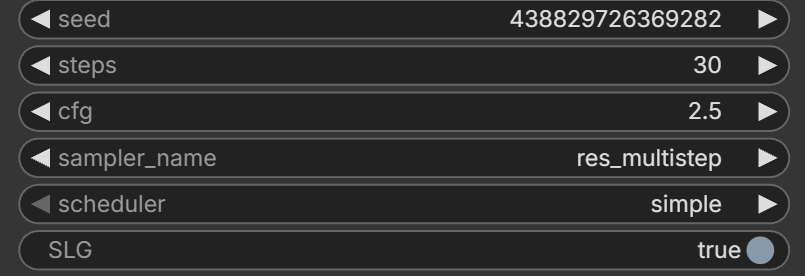
あと生成時のテキストエンコーダーはbf16版が推奨されているので、そっち使える方は使ってください。
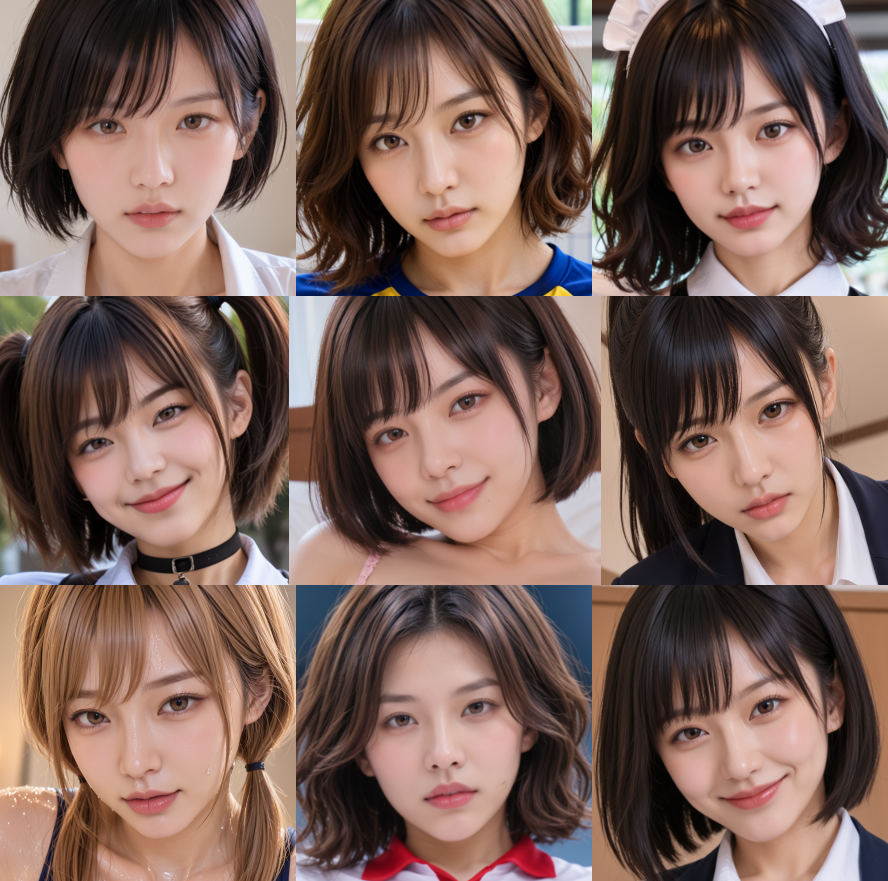
結果
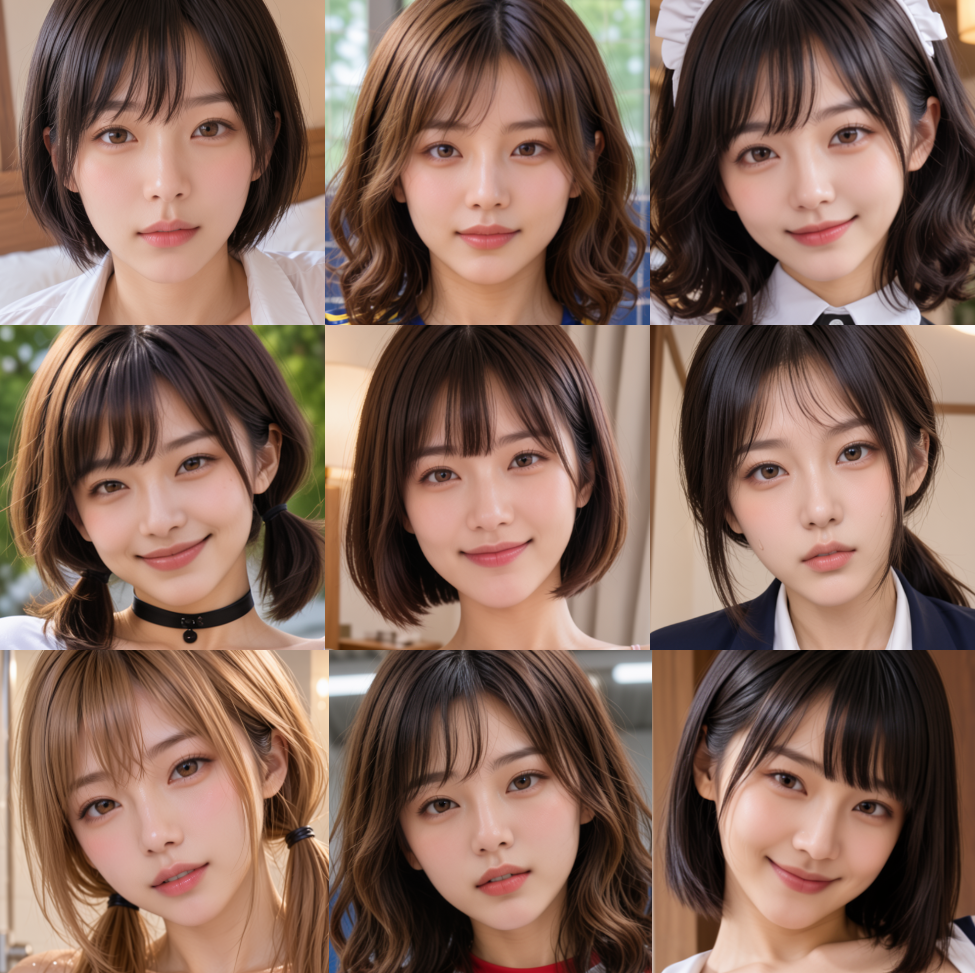
同じプロンプトで生成して顔だけ比較したものです。
・元の学習画像
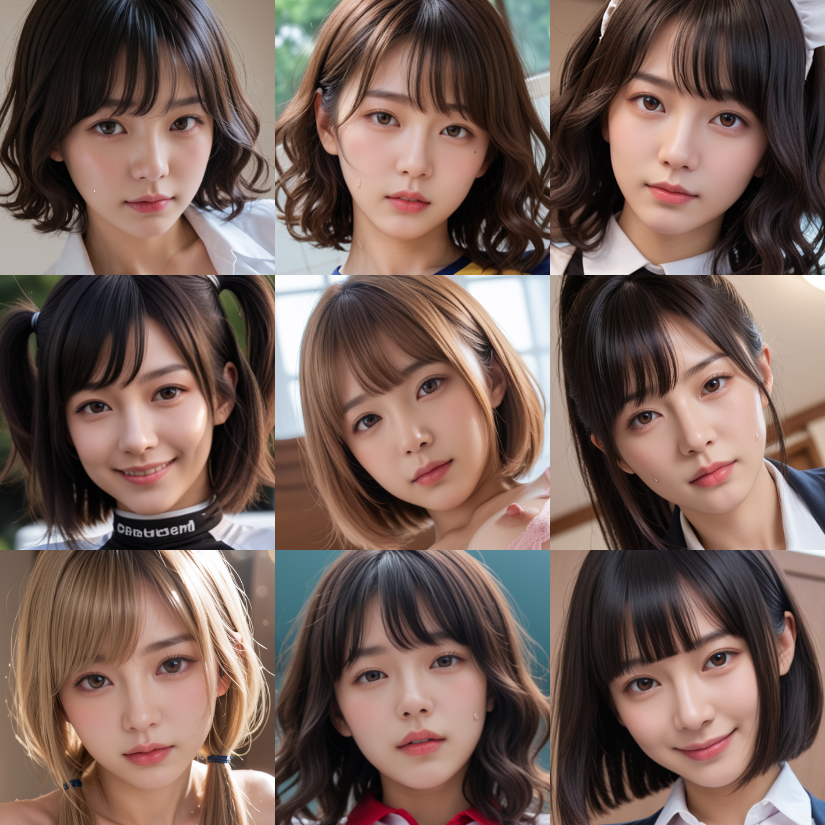
・LoRAあり・テキストエンコーダーbf16
・LoRAあり・テキストエンコーダーint8
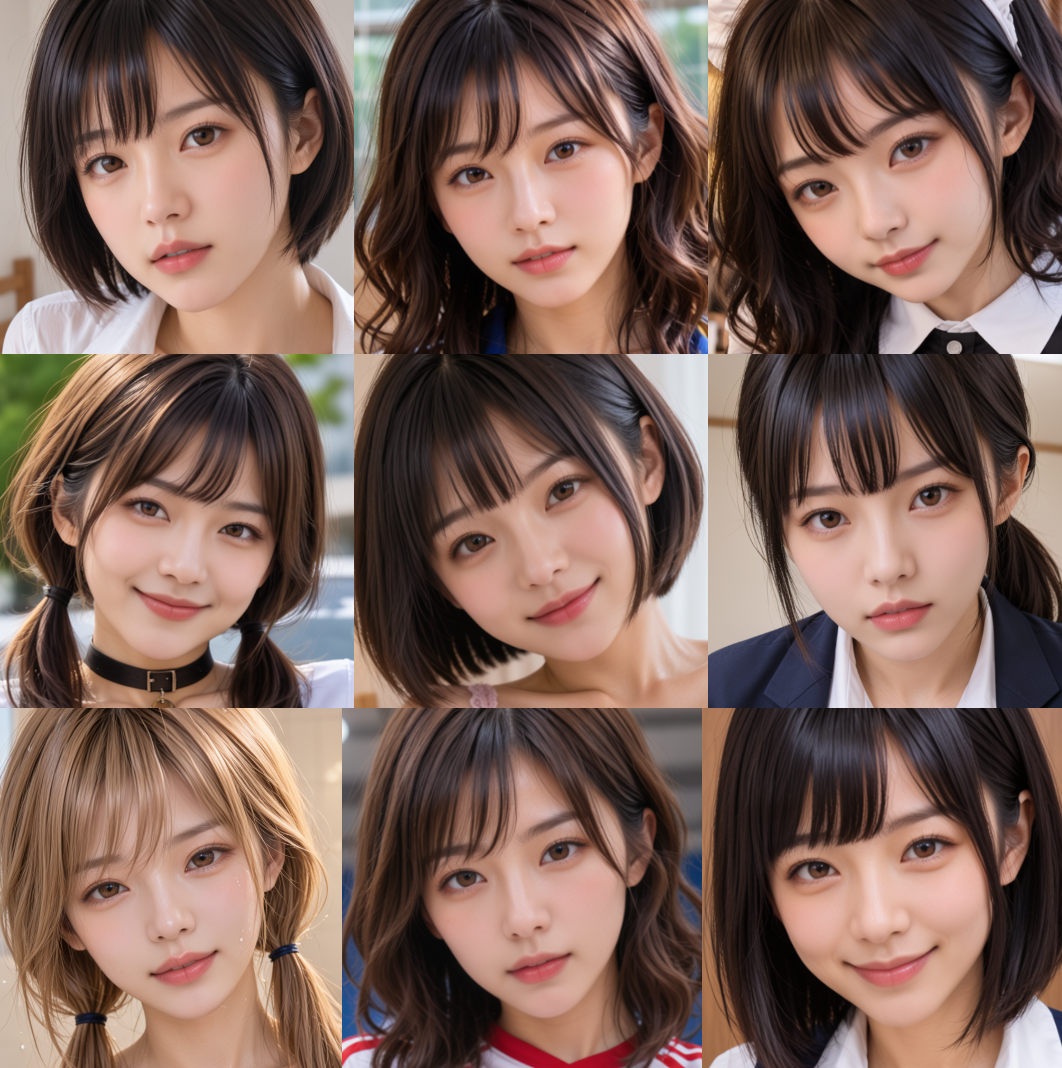
・AI ToolkitのLoRA・テキストエンコーダーbf16
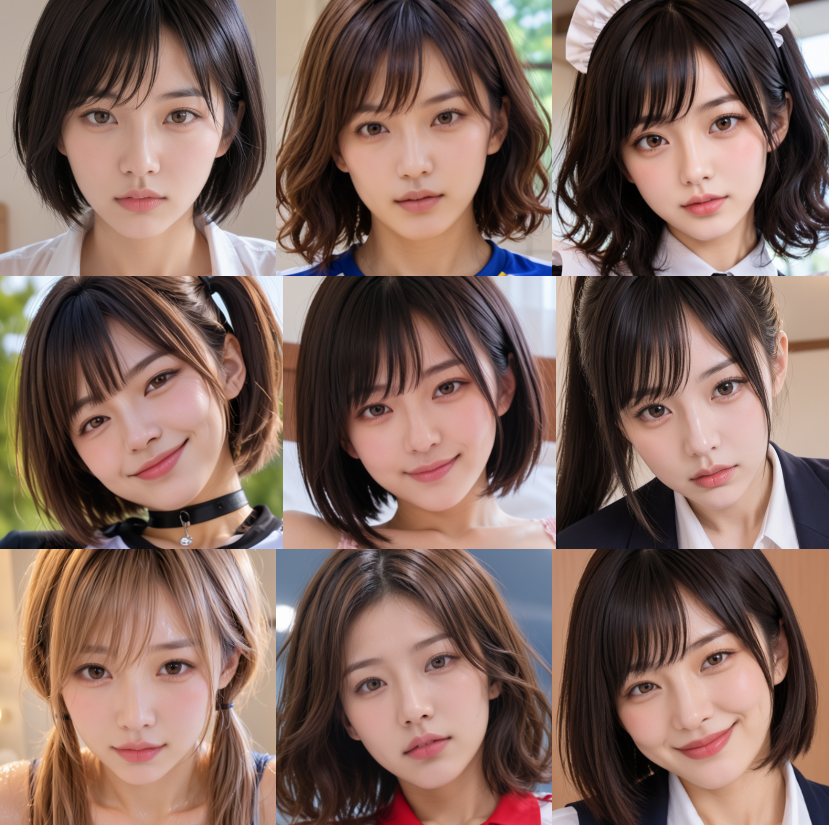
・AI ToolkitのLoRA・テキストエンコーダーint8
まとめ
Fizgigはプリセットが豊富なので、LoRA学習の設定がよく分からないって人にはかなり使いやすいと思います。
かつ結果も悪くないし、MOSS-ImageだけならAI ToolkitのLoRAよりはクオリティが良く感じました。
さらにまだ調整中とのことなので、今後はより良くなるかもしれません。
記事はMOSS-Imageでやりましたが、Animaなど別モデルもほぼ同じ操作感で学習できます。
今使用しているツールだと学習結果があまりよくない、設定が自分だとよく分からないって方にはおすすめです。
以上、Fizgigのインストールと、MOSS-ImageのLoRA学習について紹介しました。
参考になれば幸いです。