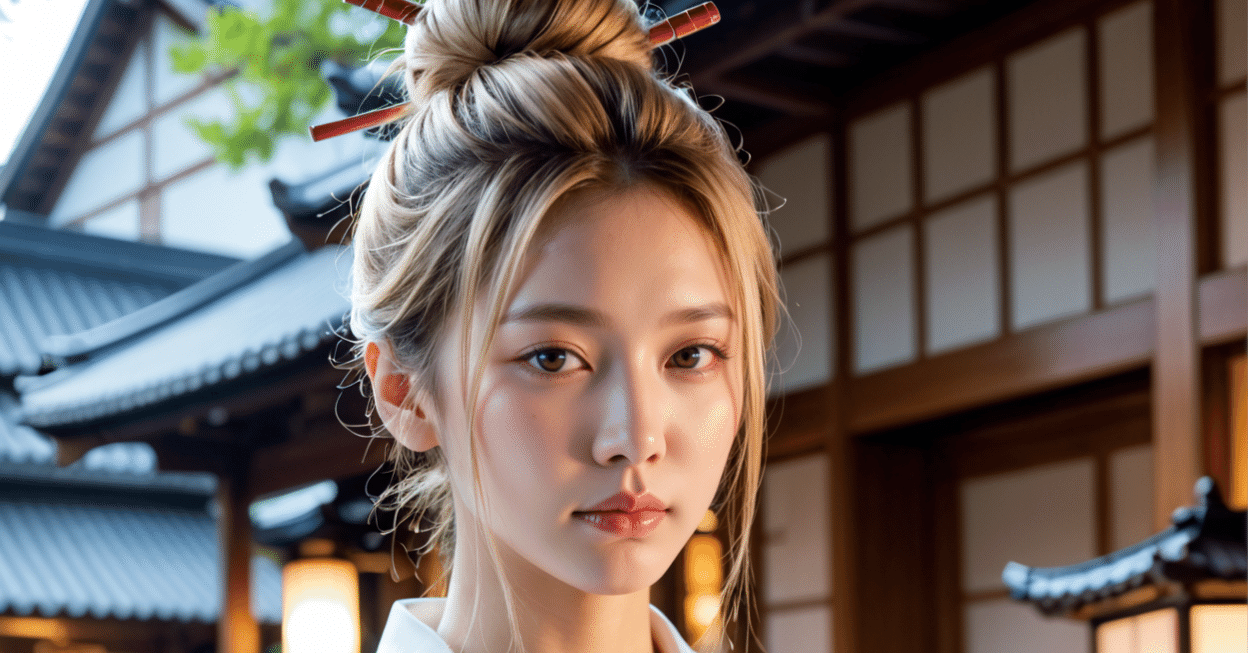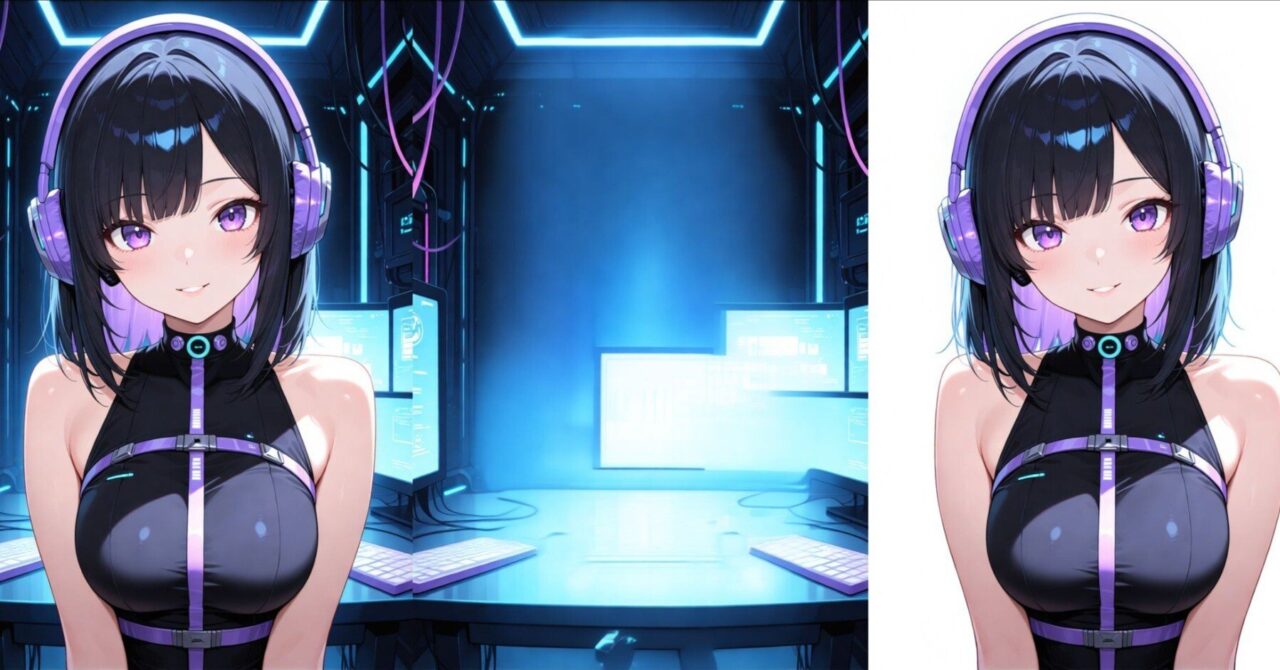
2025年12月20日にQwen-Image-Layeredがリリースされました。
Qwen-Image-LayeredがComfyUIでも使えるようになったので今回はこちらを紹介します。
Qwen-Image-Layeredとは?
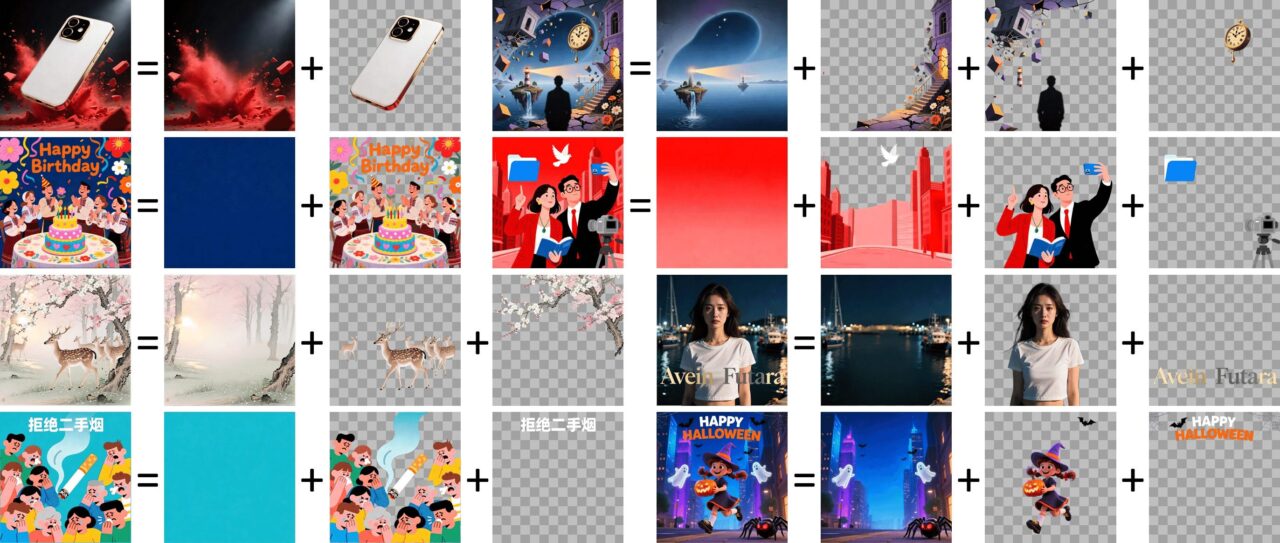
Qwen-Image-Layeredは、1枚の画像を複数のRGBA(透過情報を含む)レイヤーに分解することができるモデルです。
画像を意味のある単位や構造ごとに物理的に分離することで、元の画像に影響を与えずに特定の要素だけを編集・操作することができます。
主な特徴と機能
- RGBAレイヤーへの分解: 1枚の画像を、背景や特定のオブジェクトなど、複数の透過レイヤーに切り分ける
- 高い編集性(Inherent Editability):各レイヤーが独立しているため、他のコンテンツを損なうことなく、特定のレイヤーだけを移動、サイズ変更、再配色、削除、置換するといった操作が可能
- 可変・再帰的な分解:分解するレイヤーの数は固定されておらず(例:3レイヤーや8レイヤーなど)、必要に応じて調整できる。また、一度分解したレイヤーをさらに細かく分解する「再帰的分解」も可能。
- 高精度な操作:レイヤー化によって、オブジェクトをリサイズした際の歪みを抑えたり、不要なオブジェクトを綺麗に消去したりといった、高品質な編集を実現。
- PowerPoint形式への書き出し: 分解したレイヤーを.pptxファイルとして書き出すことができ、使い慣れたツール上で自由に配置を変えるなどの編集が行える。
なお、プロンプトは画像全体の構成を説明するためのもので、個々のレイヤーの内容を直接制御するようには設計されてないそうです。
github:https://github.com/QwenLM/Qwen-Image-Layered/tree/main huggingface:https://huggingface.co/Qwen/Qwen-Image-Layered demo:https://huggingface.co/spaces/Qwen/Qwen-Image-Layered
ComfyUIのインストール
ComfyUIのインストールがまだの方はこちらを参考にしてみてください。

Qwen-Image-Layeredの使い方
モデルの準備
diffusion_models
ComfyUIのリポジトリだとbf16とfp8があります。
ただbf16は約40GBあるのでスペック不安な方はfp8かGGUFの方が良いかもしれません。
qwen_image_layered_bf16.safetensors qwen_image_layered_fp8mixed.safetensors
・GGUF
ComfyUI\models\diffusion_modelsVAE
qwen_image_layered_vae.safetensors
ComfyUI\models\vaetext_encoders
qwen_2.5_vl_7b_fp8_scaled.safetensors
ComfyUI\models\text_encodersLoRA
一応LoRAも使えるみたいです。
ただ処理速度は上がりますが、クオリティは下がります。
ComfyUI\models\lorasworkflow
Civitaiで公開されていたのでこちらをお借りしました。
GGUF用ですがLoad Diffusion Modelにすればfp8モデルも使えます。

もう一つ通常モデル用でFlorence2を組み込んだworkflowもあります。

ただこっちは以下のカスタムノードを手動インストールする必要があります。
cd ComfyUI\custom_nodes
git clone https://github.com/DenRakEiw/ComfyUI-nearest-qwen-resolution.git
その他足りないノードがあればManager→install missing custom nodesでインストールしてください。
ノードの設定&実行
GGUF版のworkflow使ってます。
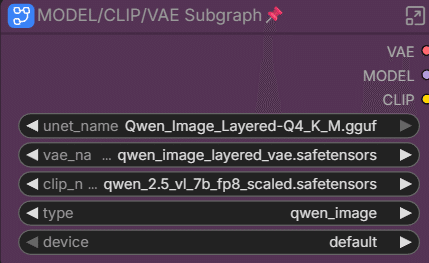
MODEL/CLIP/VAE Subgraph
GGUFモデル使う場合はここでMODEL/CLIP/VAEを指定します。
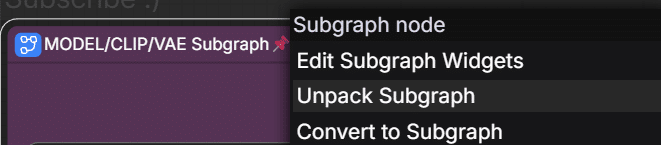
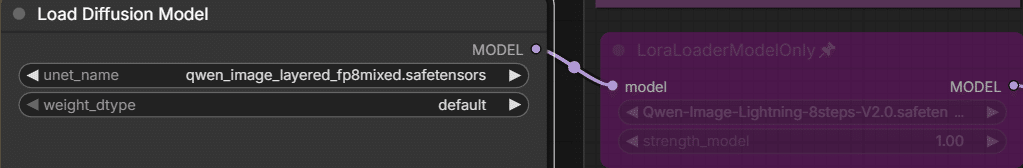
通常モデル使う場合はUnpack Subgraphで解除して、ノードを切り替えてください。
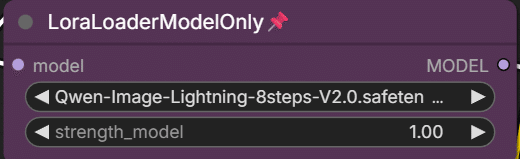
LoraLoaderModelOnly
LoRA使う場合はbypass解除して使用するLoRAを指定します。
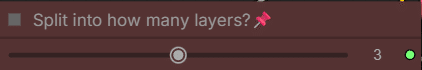
Split into how many layers?
レイヤーをいくつに分けるか指定できます。
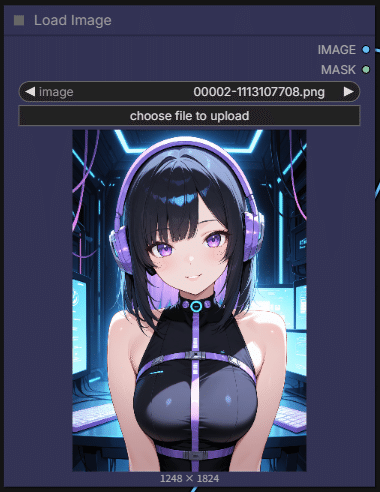
Load Image
画像を取り込みます。
Positive Prompt (Optional)
プロンプトは入れなくても機能するそうです。
特定の要素を指定して分けるのはできないそうなので、Florence-2で解析したキャプションいれときました。
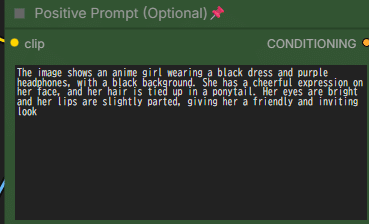
workflowに組み込んで使うこともできますが、よくわかんねって人はdemoでキャプションのみ取得できます。
結果:
モデル読み込みありで約10分(511.73 seconds)でした。
レイヤー3だとこんな感じに分かれます。
右下何もないですが一応元画像+3枚で計4つ表示されてます。
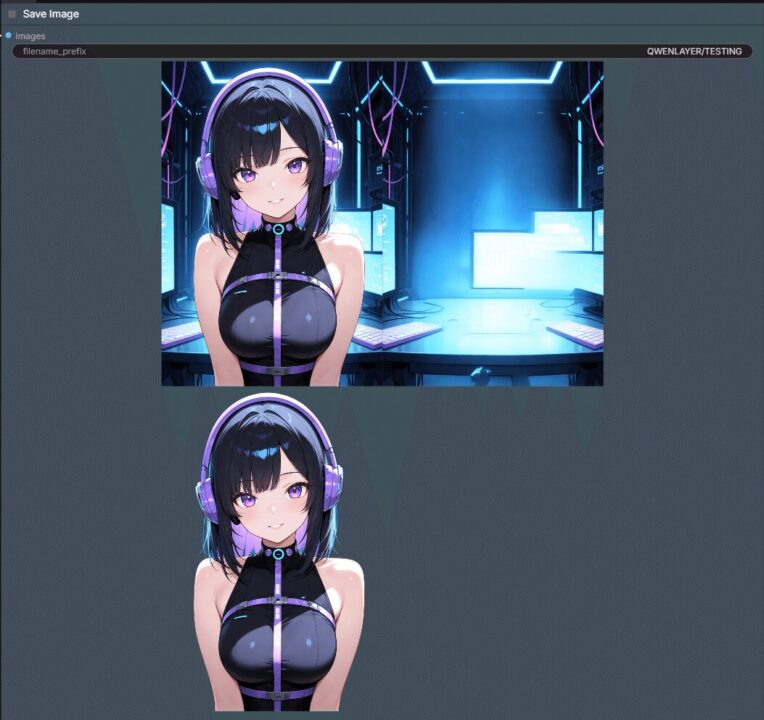
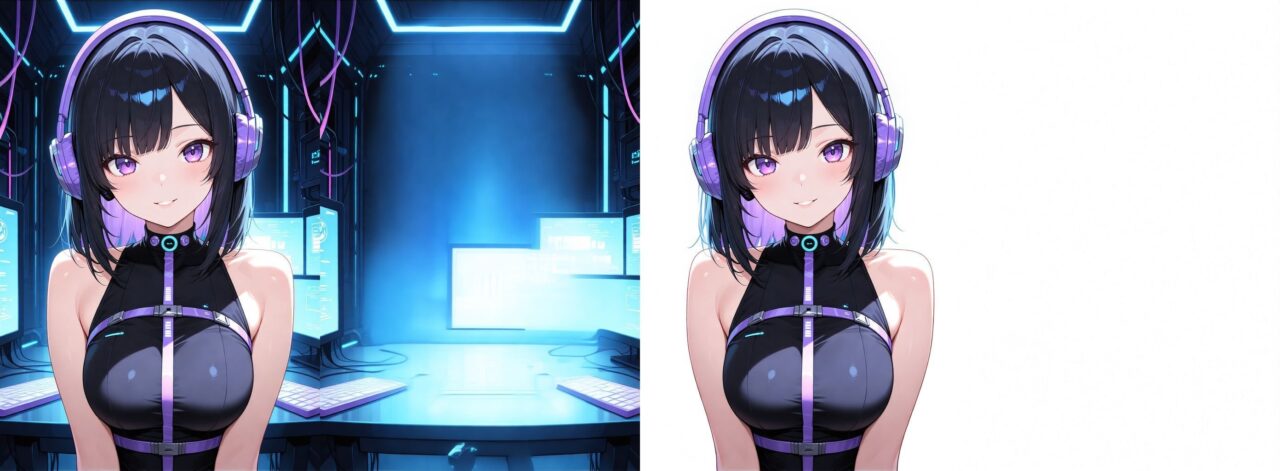
背景と被写体は綺麗に分かれてました。
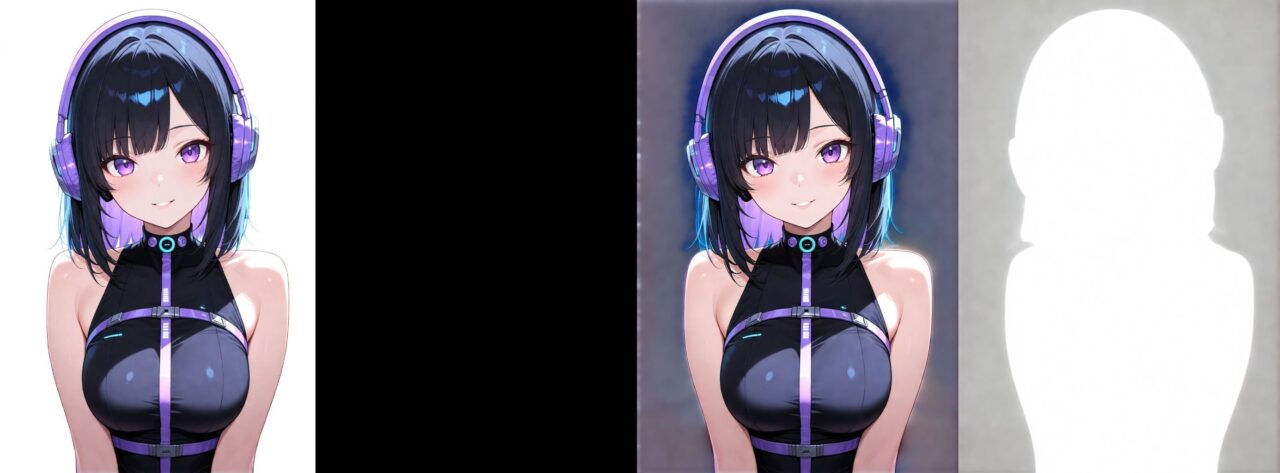
被写体だけの画像入れて実行してみたんですが、結果はイマイチでした。
Lightningの8step LoRA使うと約1分半(93.56 seconds)で処理できます。
ただこっちは劣化します。
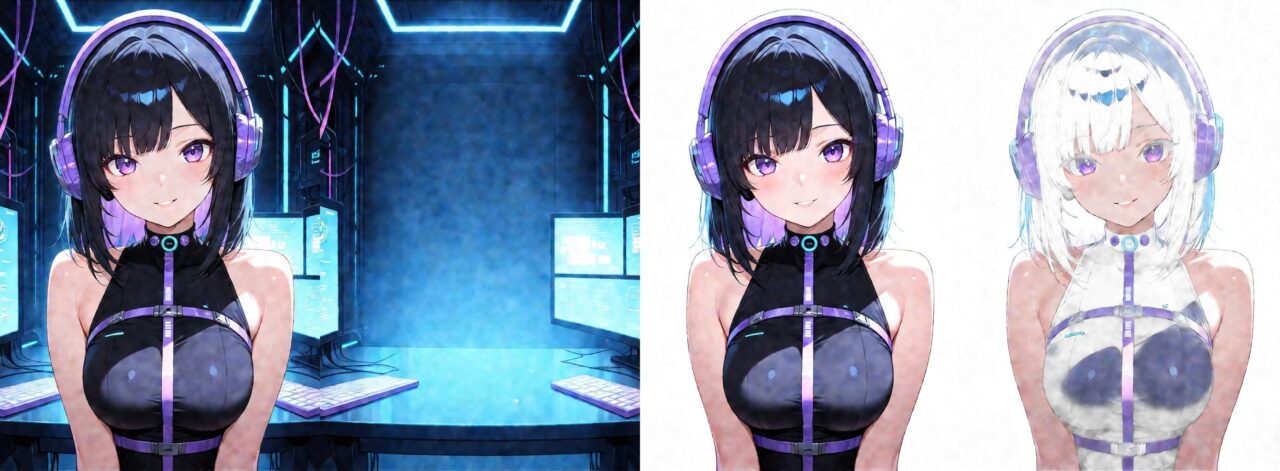
GGUFだと483.63 secondsで結果はこんな感じでした。
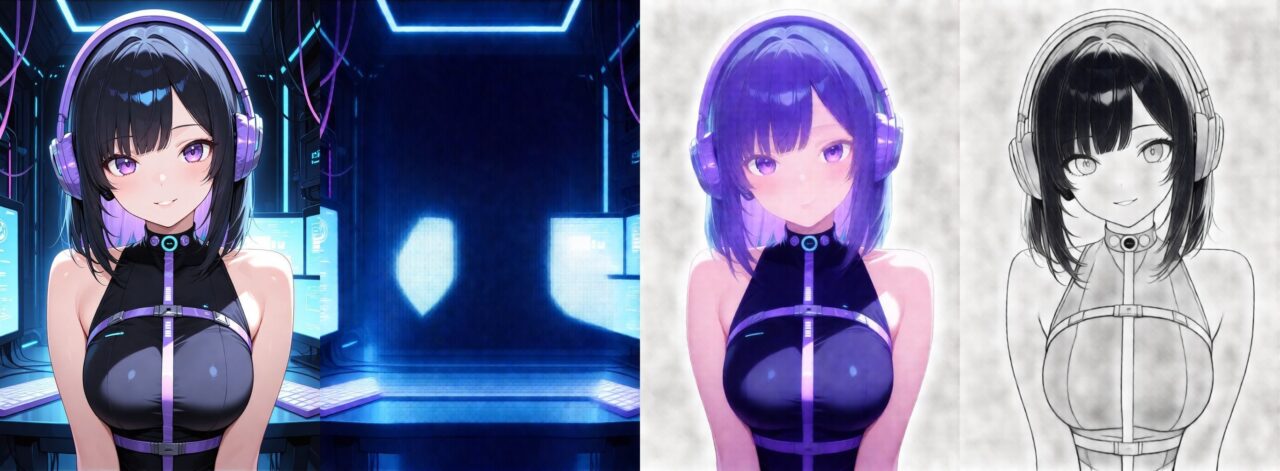
もう一つのFlorence2ありのworkflowでも結果はほぼ変わりませんでした。
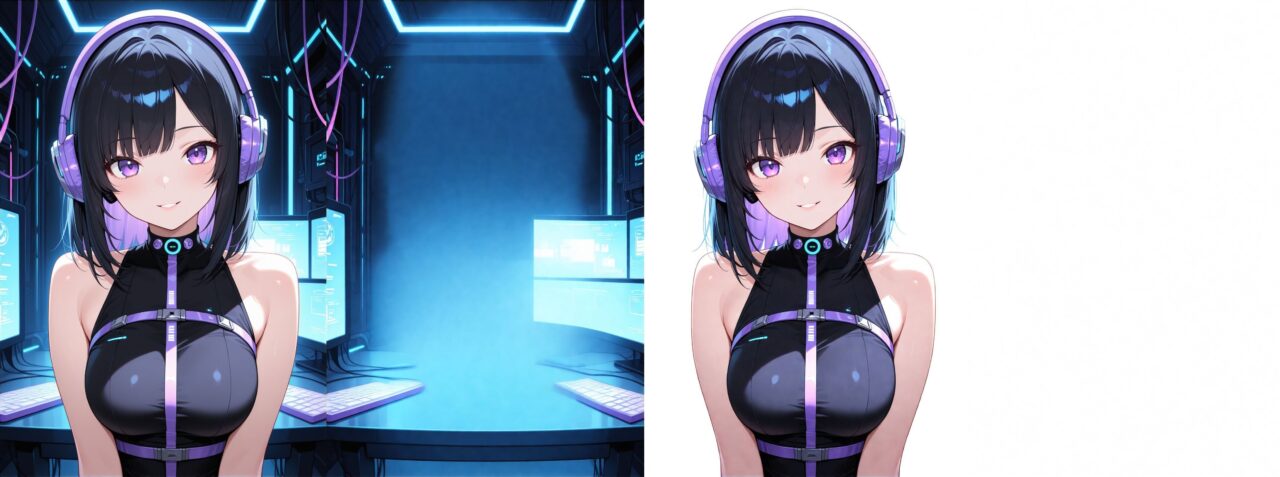
まとめ
使う前は要素を指定してレイヤー分けできればLive2d作ったりするのに便利そうだと思っていました。
ただ現時点でそういったことはできないようなので、どういうシーンで使えるモデルなのかイマイチよく分からなかったです。
Xだと綺麗に分けられてる人もいるので画像によるのかもしれません。
以上Qwen-Image-Layeredの使い方を紹介しました。
参考になれば幸いです。