ComfyUIの公式ワークフローに、Qwen Image 2.1のテンプレートが2種類追加されました。
1つのモデルでテキストからの画像生成と画像編集の両方をまかなえるので、用途ごとにモデルを入れ替える必要がありません。
この記事では必要なモデルの置き場所から、2つのワークフローの使い方までをまとめて紹介します。
Qwen Image 2.1とは?
Qwen Image 2.1は、2026年9月20日に公開されたQwenファミリーの画像モデルです。
テキストからの画像生成と、指示文による画像編集を1つのモデルで扱います。
画像を作る部分は7Bパラメータで、32層のSingle-Stream DiTという軽い構成です。
注意機構の粒度を使い分ける仕組みと、プロンプト側の計算結果をステップ間で使い回すprefix KVキャッシュによって、計算量を抑えながら画質を保っています。
主な特徴
- 画像生成と指示文による画像編集を1つのモデルで実行できる
- 画像を作る部分は7Bパラメータ・32層のSingle-Stream DiTと軽量
- 透過(RGBA)画像をそのまま生成でき、透過レイヤーの編集や写真からの被写体の切り出しにも対応
- 編集では参照画像を最大10枚まで渡せ、人物や商品の同一性を保ったまま合成できる
- 丸囲み・塗りつぶしの書き込み・マスクで、直したい場所を指定できる
- 2048×2048のネイティブ2K出力に対応し、16:9や3:2など7種類の推奨サイズがある
- 文字組み、人物のライティング、細部の質感を改善
ライセンス
Qwen Image 2.1は、Qwen RESEARCH LICENSE AGREEMENTで公開されています。
前のQwen-ImageはApache 2.0だったので、2.1から条件が変わっている点に注意が必要です。
主な条件
- 利用できるのは研究・評価といった非商用の目的だけ
- 商用で使う場合は、別途ライセンスの取得が必要
- 再配布するときはライセンス文を添え、変更した箇所を明記する
- 出力を使って学習・改良したAIモデルを公開する場合は「Built with Qwen」などの表示が必要
- 派生物や製品の主な名称に「Qwen」を使わない
生成した画像そのものの扱いについては、ライセンス本文に直接の記載がありません。
ライセンス全文をAIに読ませた見解だと、モデルを動かすこと自体が非商用に限られているため、商用目的で画像を作る場合も別途ライセンスが必要とのことでした。
その後、公式からライセンスについてポストがありました。
Outputs are not part of the licensed Materials. Users retain the rights to images and other content they generate using the model.
出力はライセンス対象のマテリアルには含まれません。ユーザーはモデルを使用して生成した画像やその他のコンテンツの権利を保持します。
これを見る限りでは、出力物に関しては非商用制限はかからないと見てよさそうです。
ただリプ欄でも混乱している方が多く、発表後も出力物の扱いがよくわからない状態になっています。
全文はリポジトリで確認してください。

ComfyUIのインストール
ComfyUIをまだインストールしていない方は、こちらを参考にしてみてください。
Qwen Image 2.1は執筆時点の安定版では動かないため、ComfyUIをnightly(masterブランチ)へ切り替える必要があります。
切り替えの手順は以下の通りです。
パスは自身のものに置き換えてください。
# StabilityMatrix
cd C:\StabilityMatrix-win-x64\Data\Packages\ComfyUI
git checkout master
git pull
.\venv\Scripts\python.exe -m pip install -r requirements.txt

# ポータブル版
cd ComfyUI_windows_portable\ComfyUI
git checkout master
git pull
..\python_embeded\python.exe -m pip install -r requirements.txt
安定版リリース後はバージョンアップだけでOKです。
Qwen Image 2.1の使い方
必要なモデルファイルと配置先
workflowはデフォルトでint8を使ってるのでこの記事でもint8を使います。
環境に余裕があり、bf16を使いたい方はrepoからDLしてください。
どちらか1つあれば動かせます。
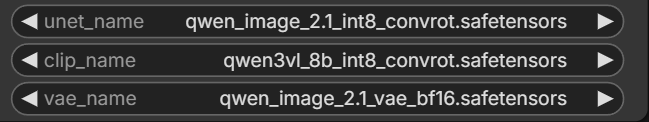
| 種類 | ファイル名 | 配置先 |
|---|---|---|
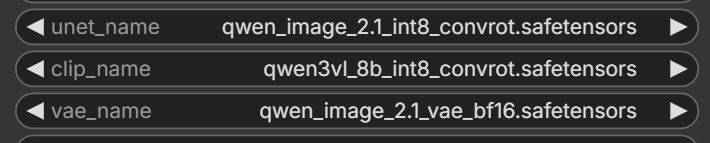
| diffusion_models | qwen_image_2.1_int8_convrot.safetensors | ComfyUI/models/diffusion_models |
| text_encoders | qwen3vl_8b_int8_convrot.safetensors | ComfyUI/models/text_encoders |
| vae | qwen_image_2.1_vae_bf16.safetensors | ComfyUI/models/vae |
配置後のフォルダ構成は以下の通りです。
ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   └── qwen_image_2.1_int8_convrot.safetensors
│   ├── text_encoders/
│   │   └── qwen3vl_8b_int8_convrot.safetensors
│   └── vae/
│       └── qwen_image_2.1_vae_bf16.safetensors
ワークフローの読み込み
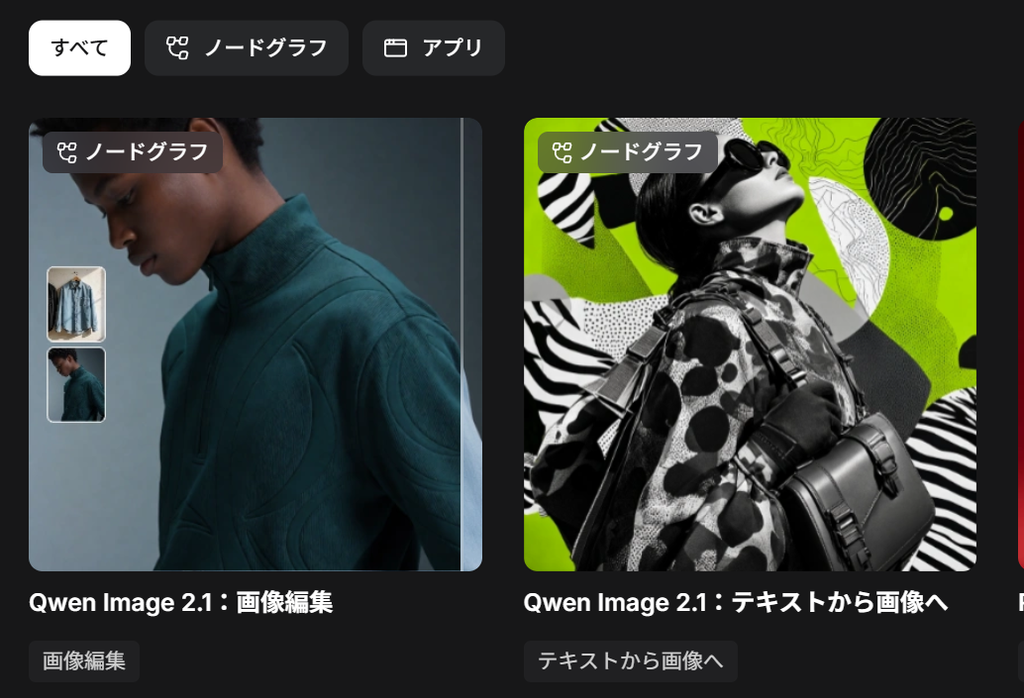
公式テンプレートは2種類です。
- テキストから画像を作るQwen Image 2.1: Text to Image
- 画像を編集するQwen Image 2.1: Image Edit
ComfyUIの左上メニュー→テンプレートを参照からも選択して読み込めます。
テキストから画像を作る(Text to Image)
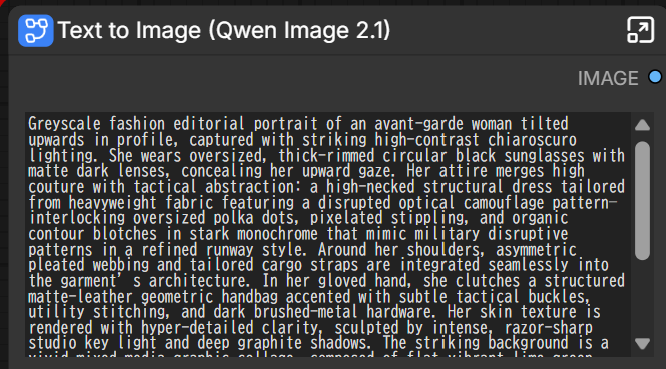
Text to Image (Qwen Image 2.1)でモデルをセットします。
上の入力欄で生成したい内容のPromptを入れてください。
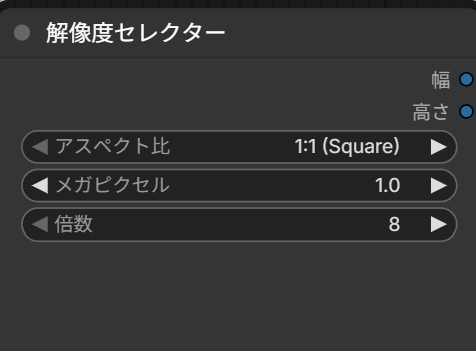
Resolution Selectorで解像度も変えられます。
2Kで出力したい場合は、公式だとmegapixels4.0、step40が推奨されています。
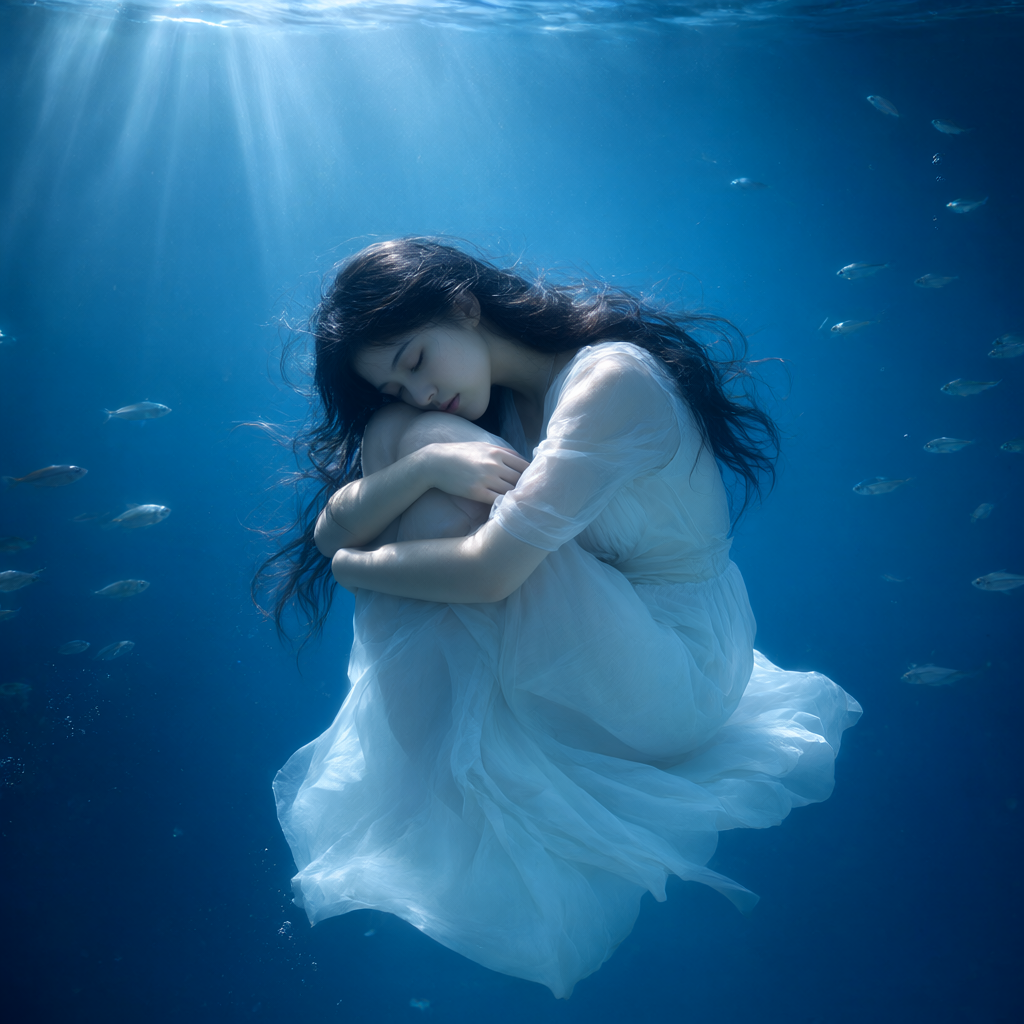
・結果
Promptは後述してるPrompt Rewriterで出力したものを使っています。
VRAM 16GB/RAM 64GB環境で17.4秒でした。
・アニメ調
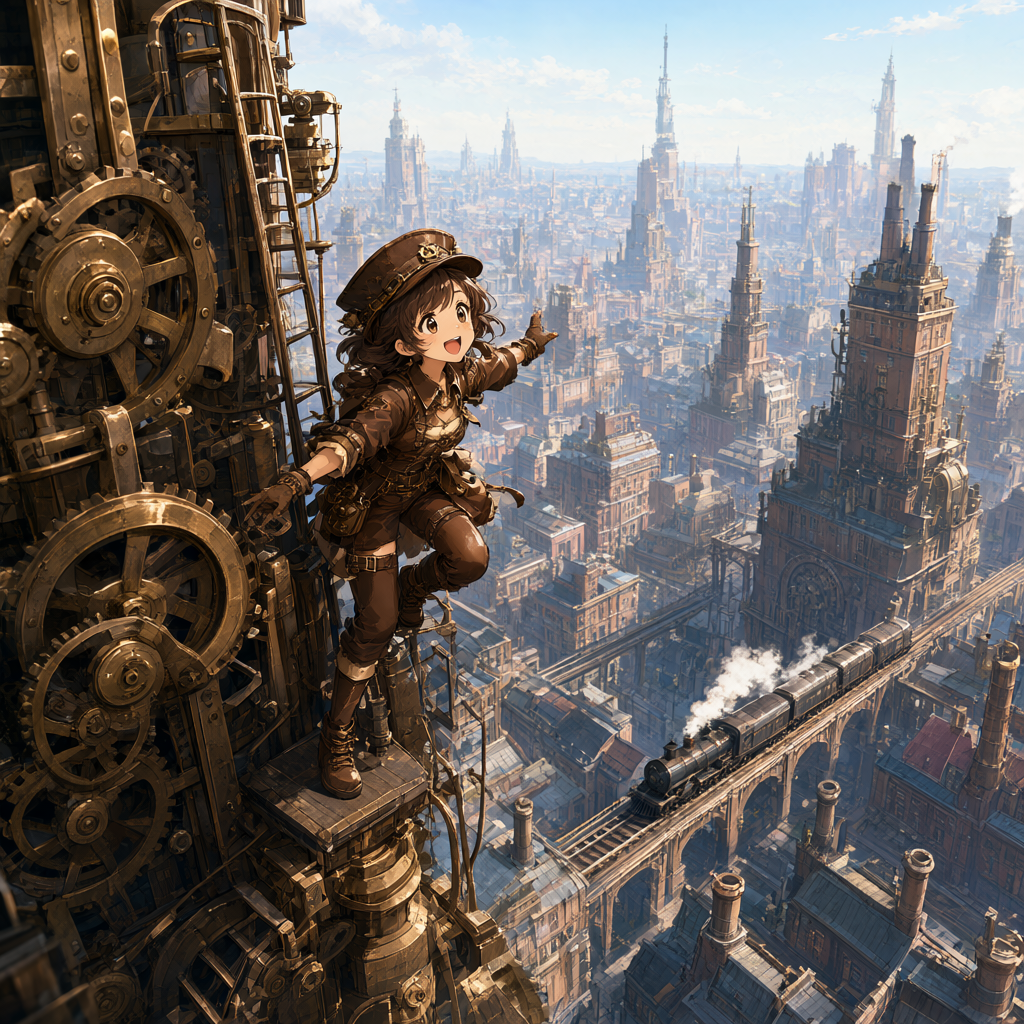
・アニメ調(2K ver)
40stepで生成して2分30秒でした。
画像を編集する(Image Edit)
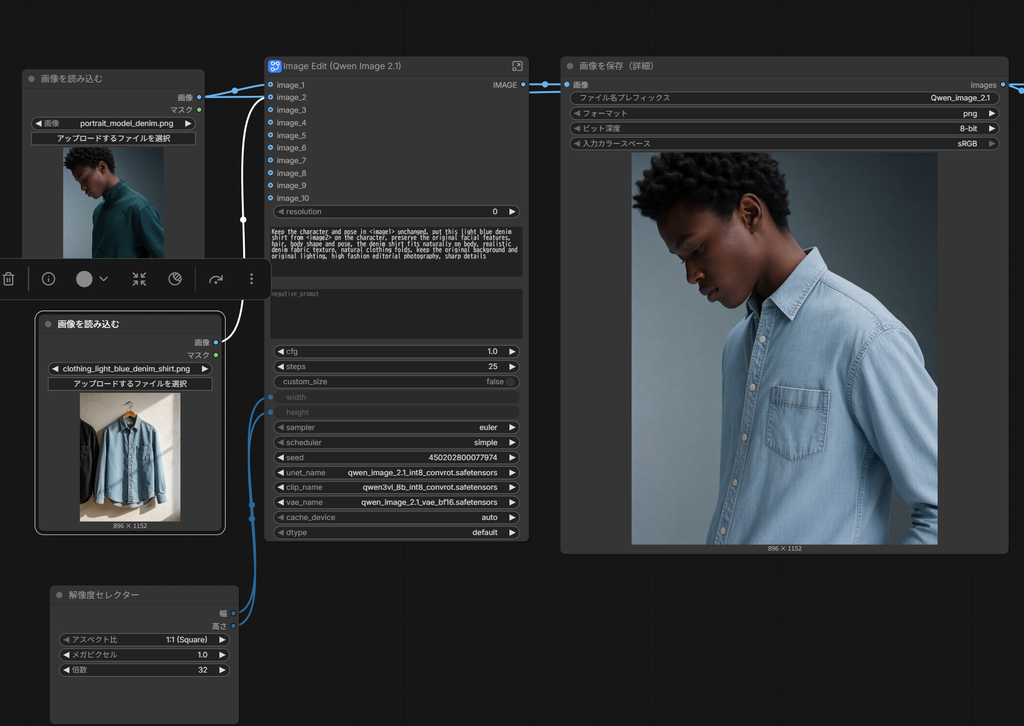
Image Editのワークフローは、参照画像を読み込んで、編集した結果を元画像と並べて確認できます。
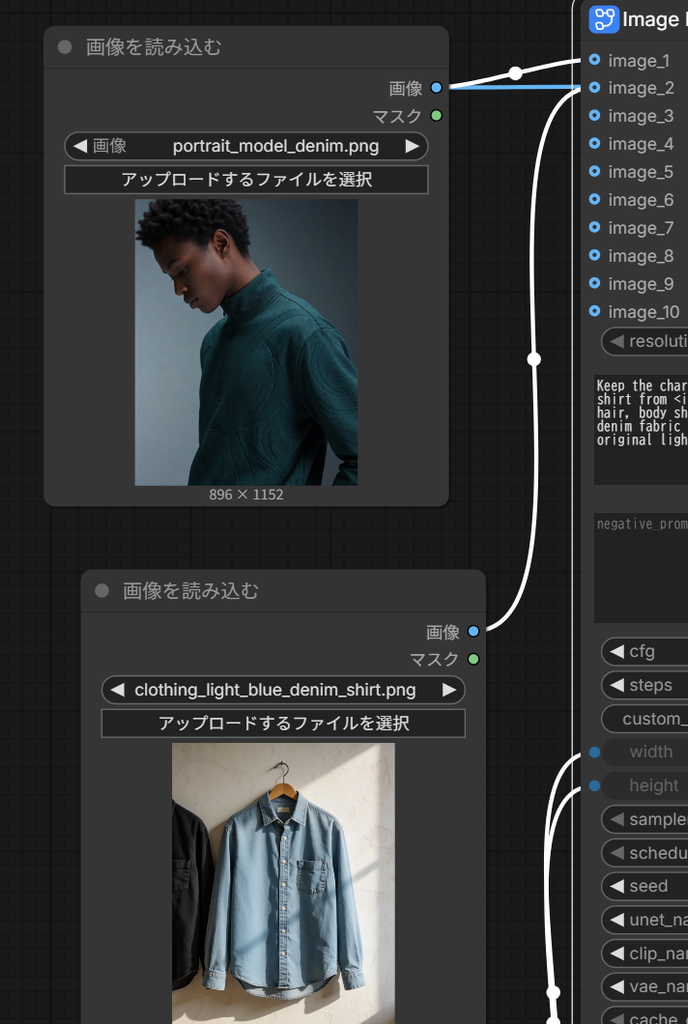
image_1が編集対象で参照画像として使いたいものを2~10にセットするようです。
デフォルトではimage_1に対してimage_2の服を着させるみたいなことしてます。
まず真ん中のサブグラフでモデルをセットしてください。
編集したい画像と任意の参照画像をセットします。
ノードを追加すれば最大10枚まで接続可能です。
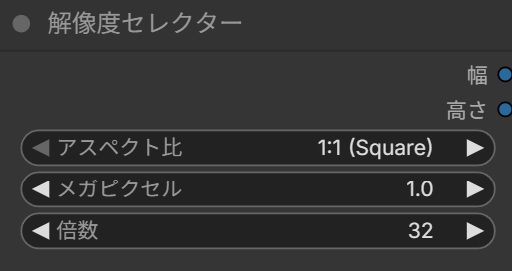
Resolution Selectorで解像度やアスペクト比を変えられます。
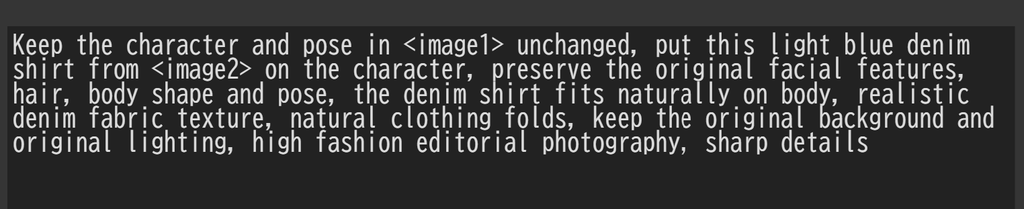
あとはどう編集したいかPromptを書いて生成するだけです。
「<image1>に<image2>を着させる」みたいな書き方をします。
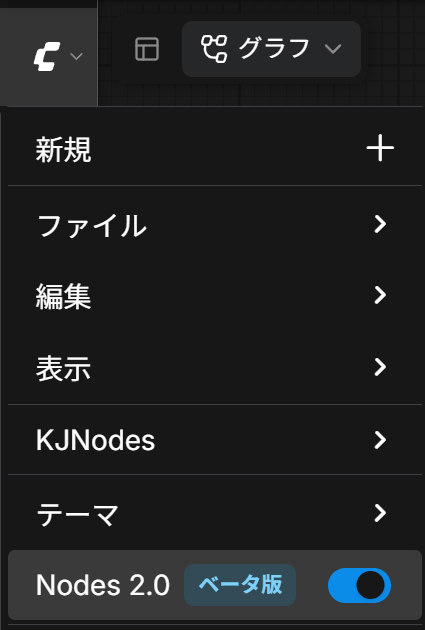
画像比較したい場合はNodes2.0をONにしてください。
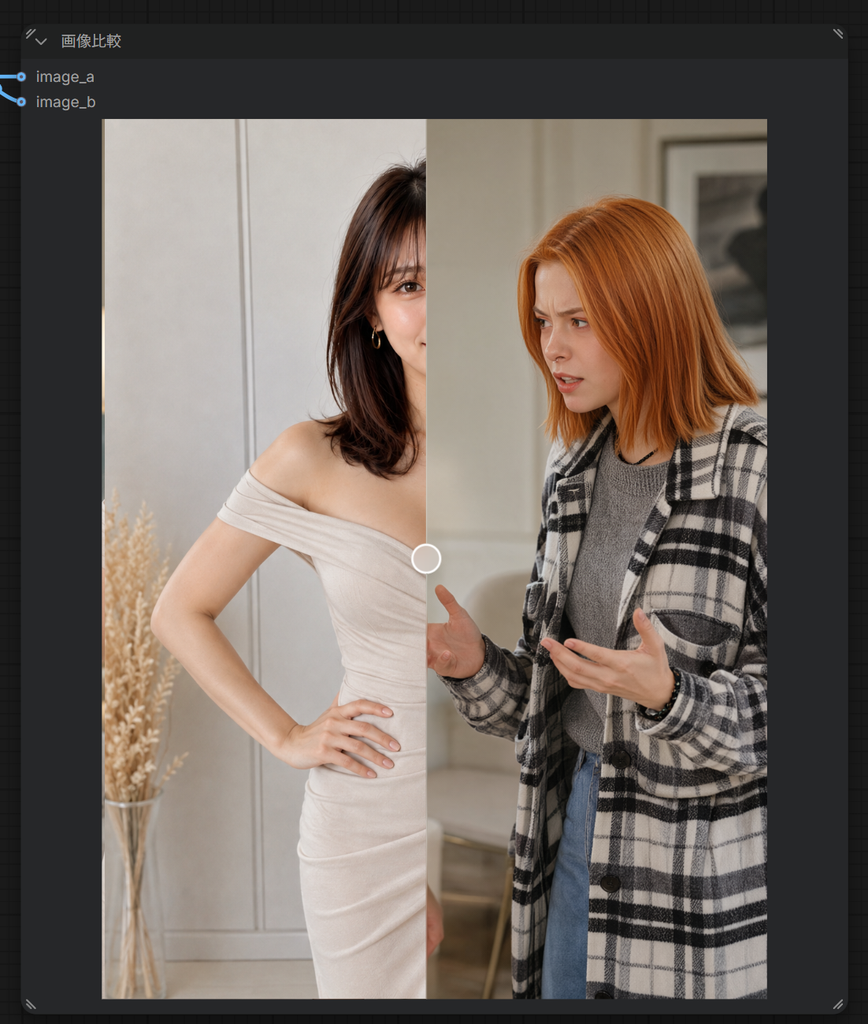
・結果
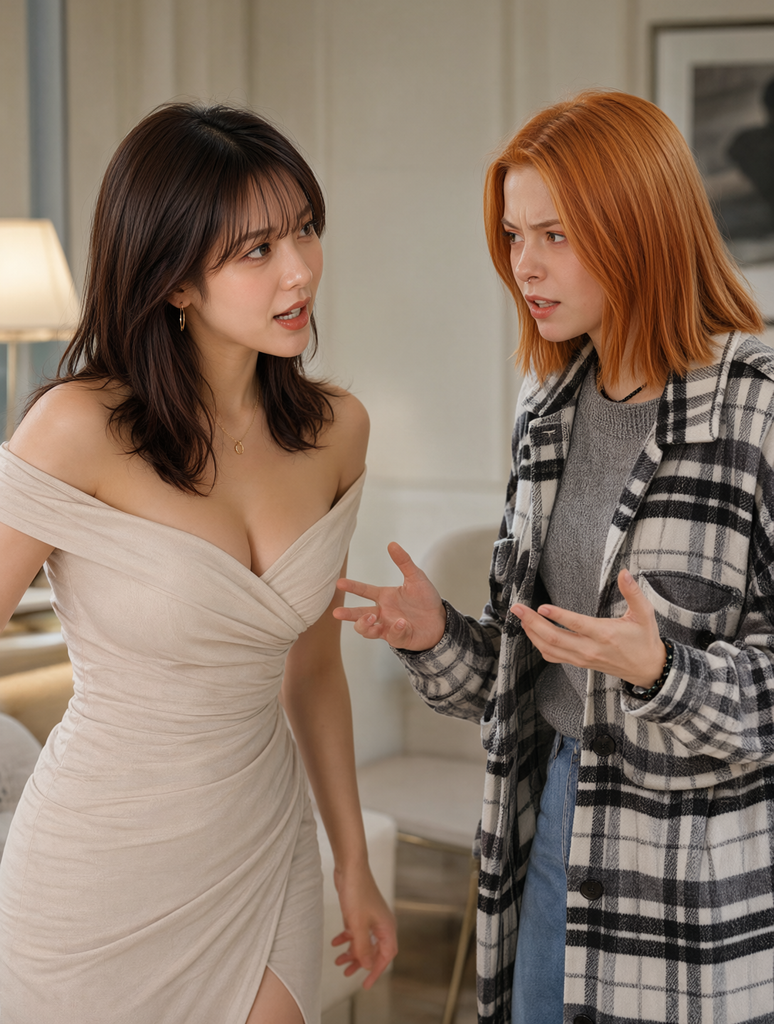
参照画像2枚で女性が言い合いしているみたいなシーンを作って、生成は1分39秒でした。
出力サイズの決まり方
Qwen Image 2.1は2048×2048のネイティブ2K出力に対応しているそうです。
custom_sizeがオフの初期状態では、image_1のアスペクト比に合わせて、resolutionで指定した大きさ(初期値1024、32の倍数)へスケールされます。
image_1の元のピクセルサイズがそのまま使われるわけではありません。
元のサイズを保ちたい場合は、resolutionを0にしてください。
その場合も32単位に丸められます。
custom_sizeをオンにした場合は、ResolutionSelectorのwidth/heightがキャンバスサイズです。
リサイズ後のimage_1のサイズから離れた値にすると、編集結果がずれることがあります。
Promptの書き方
GithubにLLMに書かせるためのPrompt Rewriterという仕組みが用意されています。
リポジトリをcloneしてスクリプトを実行する形です。
書き換え用に追加学習したQwen3.5-VL 9B(約19GB)を使ってPromptを出力できます。
git clone https://github.com/QwenLM/Qwen-Image-2.1
cd Qwen-Image-2.1/prompt_rewrite
pip install -r requirements.txt

python run_transformers.py --task t2i --ckpt Qwen/Qwen-Image-2.1-PE-T2I --input data/t2i_example.jsonl --output out.jsonl
実行するとモデルが自動DLされ、短い指示を書いたJSONLを渡すと、out.jsonlへ出力されます。
画像編集で使うときは、–task editに変えてckptをQwen/Qwen-Image-2.1-PE-I2Iにしてください。
ただモデルが重い、コマンドだとよく分からないという場合は指示文(system prompt)だけAIチャットとかに渡して、「指示文参照して以下の要素から画像生成用Promptを出力してください」とか言えば出力してくれます。
- テキストから画像:system_prompt_t2i.txt
- 画像編集:system_prompt_edit.txt
そのままだとjsonlで出力するようになってるので、使用部分だけ手動でコピーしてください。
画像編集のほうは、元になる画像も一緒に渡す必要があります。
まとめ
Redditなどでも言われてたのですが、アニメ調だと手が崩れたり少し描写が甘いように感じました。
リアル系は綺麗だし、生成も高速だし、Promptの追従性も良さそうなので、いろんなシーンで役立てると思います。
Licenseに関しても追加のポストを見る限り、出力物に関して商用利用可能と読めます。
ただ若干表現が曖昧なのと確信が持てないので、もう少し様子見した方が良いかなという感じでした。
以上Qwen Image 2.1の使い方を紹介しました。
参考になれば幸いです。