TencentのWeChat Vision Teamが公開したWeVisOne-VLが、ComfyUIでネイティブに使えるようになりました。
テキストで指定した対象を画像から見つけ出し、アルファマットやボックスとして返してくれるモデルです。
この記事では、公式ワークフローでの画像セグメンテーションのやり方と、実写・イラストでの切り抜き例を紹介します。
WeVisOne-VLとは?
WeVisOne-VLは、TencentのWeChat Vision Teamが開発した視覚言語モデルです。
名前はWeChat Vision All-in-Oneの略で、物体レベルの認識とピクセルレベルの認識を1つのモデルにまとめています。
物体レベルでは物体検出・参照表現による位置特定・カウント・ポインティング・OCR、ピクセルレベルでは参照セグメンテーションとアルファマッティングに対応。
点やボックスから2値マスク、連続的なアルファマットまで、ユーザーが指定した粒度で対象の位置を出力できる仕組みです。
主な特徴
- 検出・参照・カウント・ポインティング・OCR・セグメンテーション・マッティングを1つのモデルでこなす
- 960万パラメータの軽量なピクセルデコーダーでマスクとアルファマットを出力し、SAMを必要としない
- 画像内に存在しない対象を問われた場合は、ハルシネーションせずNoneを返す
- Qwen3-VLをベースに構築されている
- 2Bと4Bの2サイズを公開

ライセンス
WeVisOne-VLのライセンスはApache License 2.0です。
特記がない限りTencentが作成したコードが対象で、サードパーティのコンポーネントは元のライセンスと著作権表示を引き継ぎます。
公開の目的は、視覚グラウンディング、参照セグメンテーション、画像マッティングなどの研究とのこと。
影響の大きい判断を自動で行う用途や、個人の識別には向けていないとされています。

ComfyUIのインストール
ComfyUIをまだインストールしていない方は、こちらを参考にしてみてください。
WeVisOne-VLは、v0.46.0から対応しているため、アップデートも必要です。
Stability Matrixならパッケージ画面から更新、ポータブル版ならupdateフォルダのupdate_comfyui_stable.batで更新できます。
詳細は公式のドキュメントでご確認ください。
必要なモデルのダウンロードと配置
公式ワークフローが2Bモデルのint8版を使っているので、同じものを使います。
他にも4Bやbf16版もありますが、4Bは重く遅いそうです。
int8版は小さめのGPUに収まると公式ワークフローのNoteで案内されています。
| 種類 | ファイル名 | 配置先 |
|---|---|---|
| テキストエンコーダー | wevisone_vl_2b_int8_convrot.safetensors | models/text_encoders |
 ComfyUI/
└──  models/
    └──  text_encoders/
        └── wevisone_vl_2b_int8_convrot.safetensors
ワークフローの読み込み
utility_image_segment_wevisone_vl.jsonから、JSONをダウンロードしてD&Dしてください。
またはComfyUIのメニューからテンプレートを参照して、Image Segmentation: WeVisOne-VLから読み込めます。
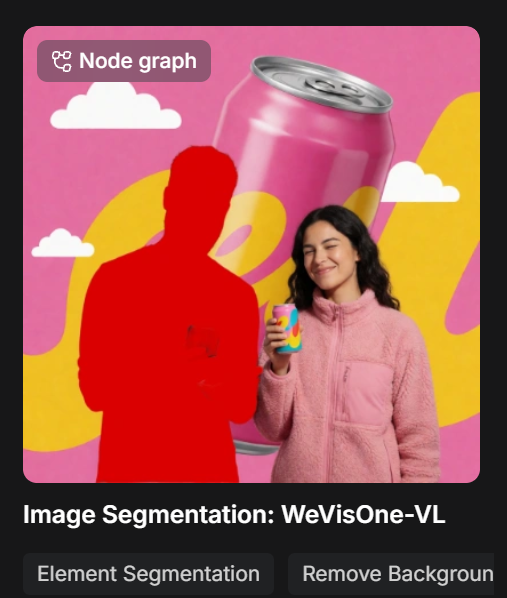
WeVisOne-VLでテキスト指定の画像セグメンテーション(背景切り抜き)
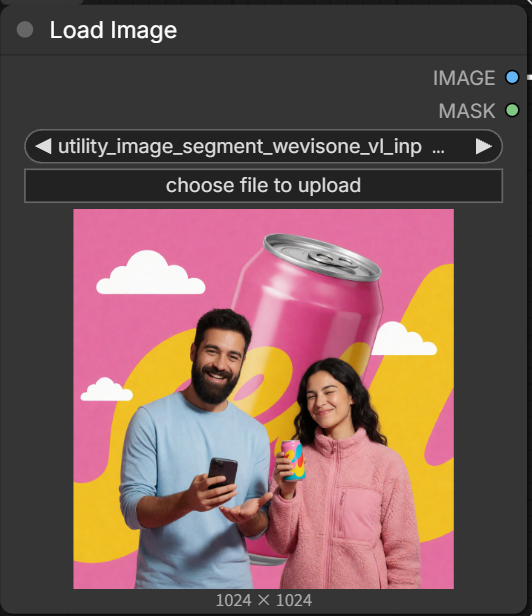
まずLoad Imageで切り抜きたい画像を読み込みます。
WeVisOne-VL Segmentでモデルを指定して、何を切り抜きたいか自然言語で指定します。
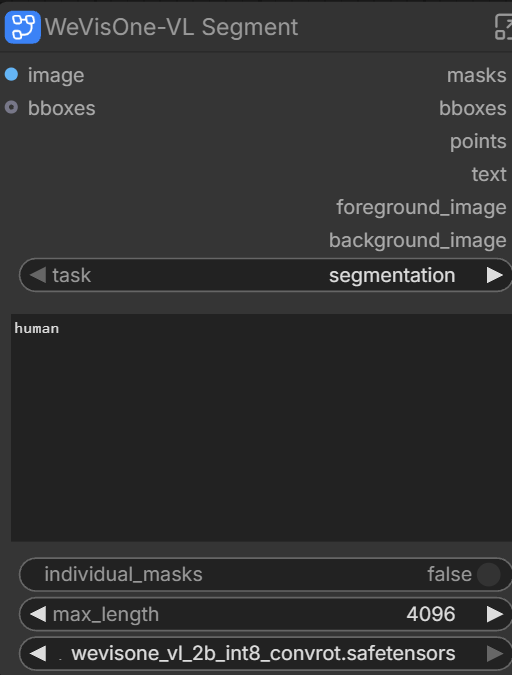
taskを切り替えると切り抜き以外にも検知できます。
以下AIにまとめてもらったもの。
| task | 意味 | 内容 |
|---|---|---|
| segmentation | セグメンテーション | 指定した対象を背景から切り抜ける。境目の半透明な部分まで含めて抜くので、背景除去や別の画像との合成に使える。このワークフローの初期設定 |
| detection | 物体検出 | 人・車など指定した種類の物を画像から探し、どこにあるかを枠で示せる。1行に1つずつ書けば複数の種類をまとめて探せる |
| referring | 参照表現での位置特定 | 「左のカップ」のように説明で指定して、条件に合う物だけを見つけて枠で示せる |
| point | ポインティング | 指定した物の位置を、枠ではなく中心の1点で示せる。位置を座標の数値として取り出せる |
| count_box | ボックスで数える | 指定した物が画像にいくつあるか数えられる。数えた1つずつに枠が付くので、どれを数えたか確かめられる |
| count_point | 点で数える | 指定した物が画像にいくつあるか数えられる。数えた1つずつに点が付く |
| ocr | 文字認識 | 画像に書かれている文字を読み取れる。単語ごとに、どこに書かれているかも枠で示す |
| ocr_grounding | 指定した文字の位置特定 | 指定した文字が画像のどこに書かれているかを探し、枠で示せる |
| visual_prompt | 参照ボックスから類似物を探す | 文字ではなく見本の枠で指定して、それと似た物を画像から探せる。名前で言いにくい物を探すときに使える。先にBounding Boxのノードをつなぐ必要がある |
| freeform | 自由入力 | queryに書いた指示をそのままモデルに送れる。上の9種類に当てはまらない使い方を試すときに使う |
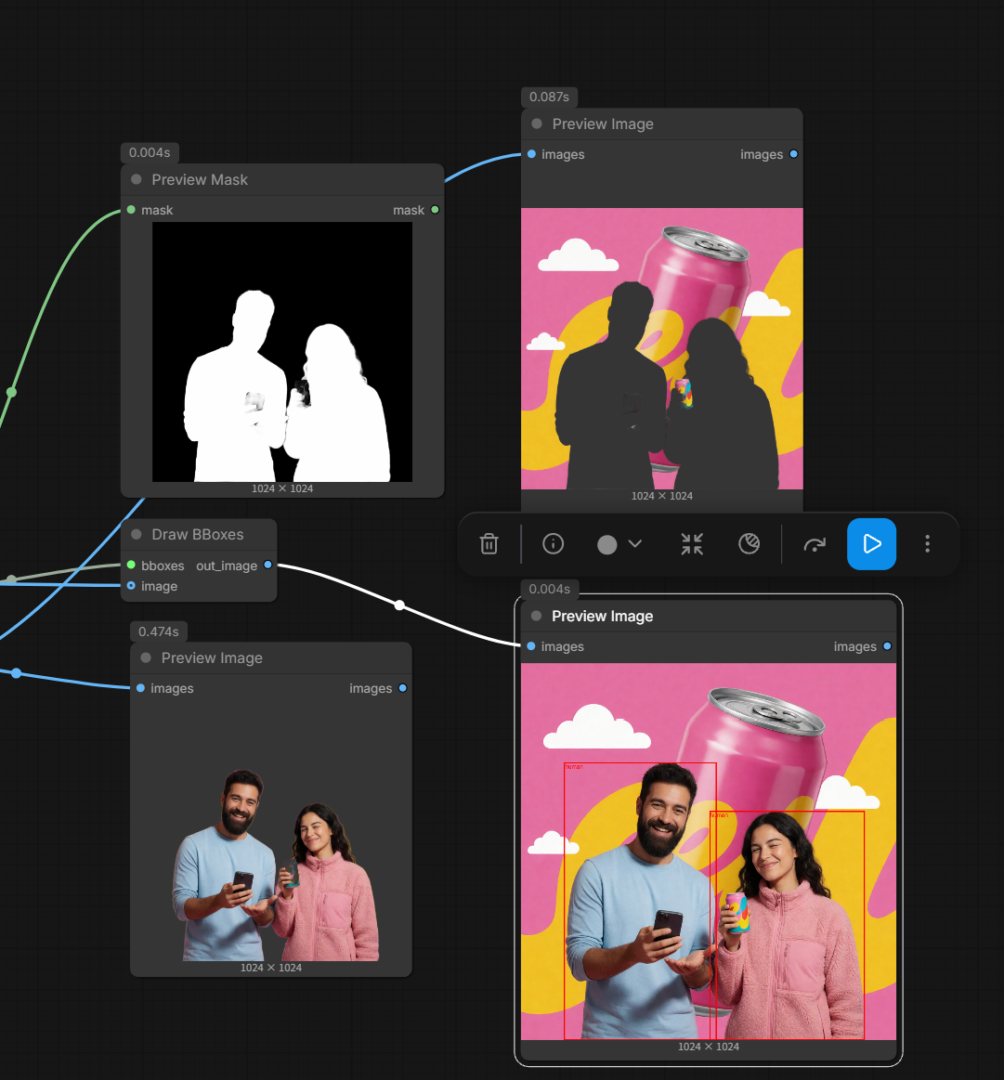
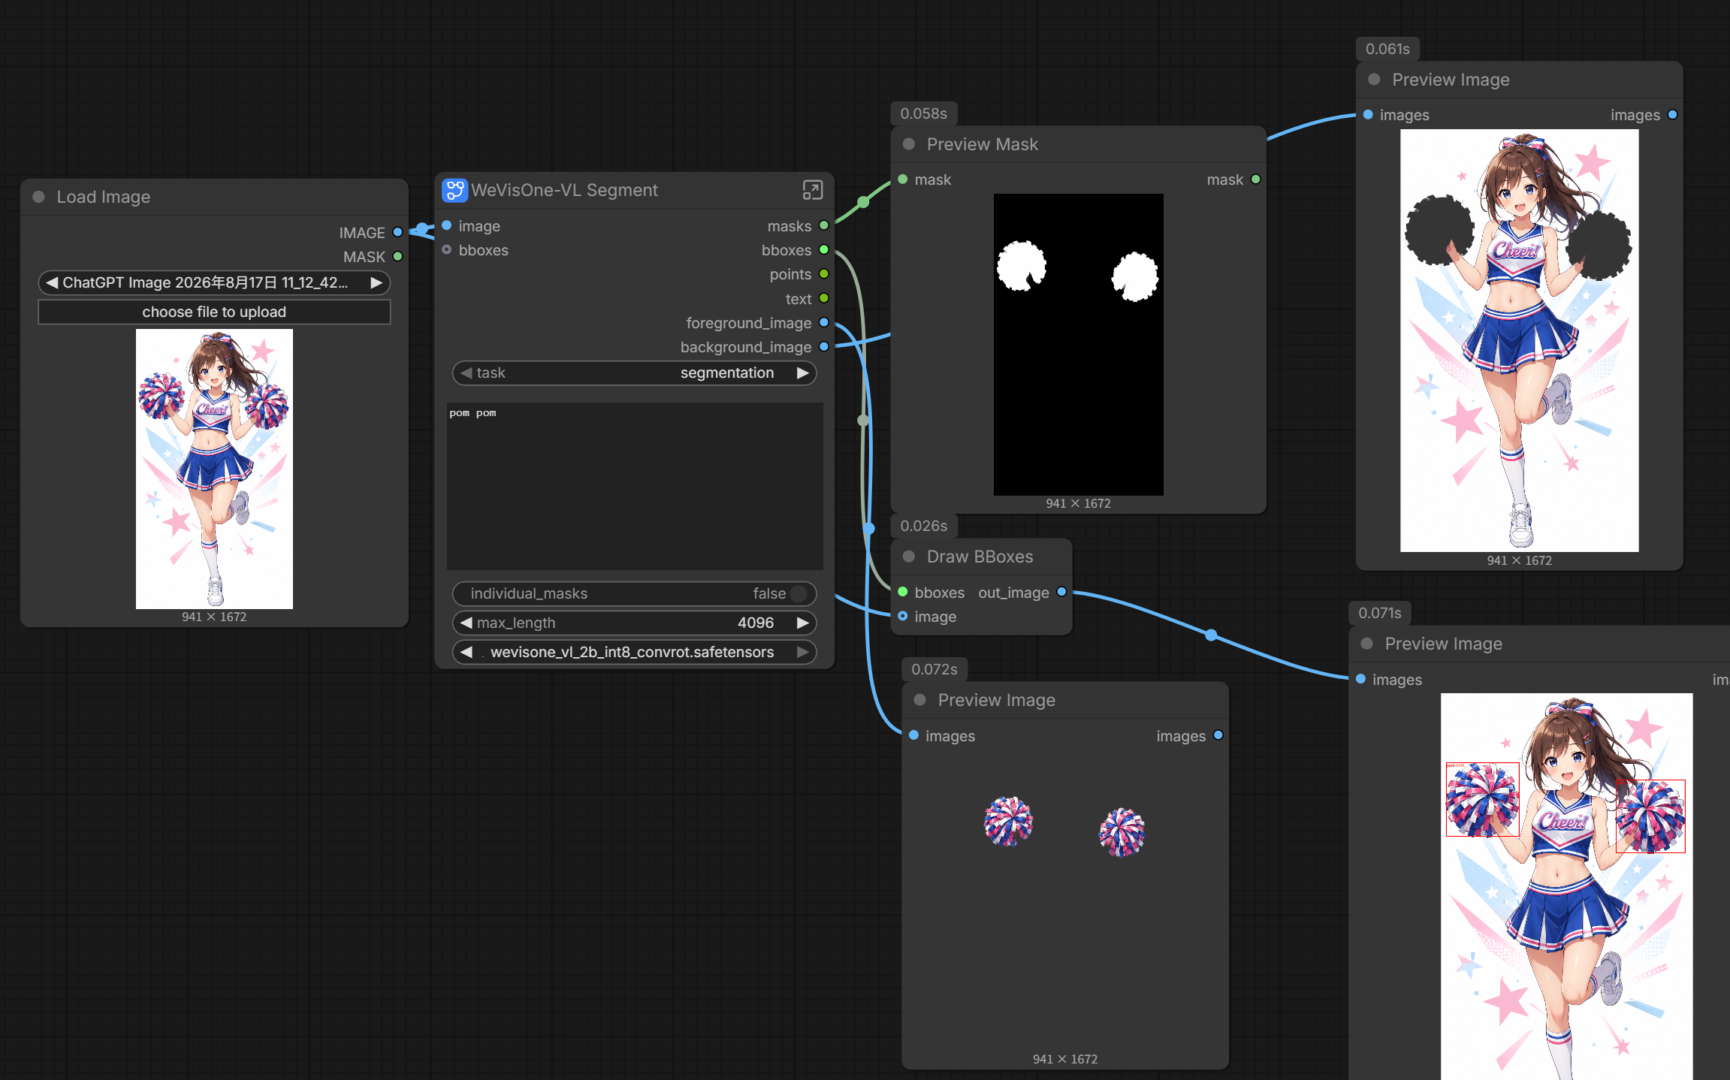
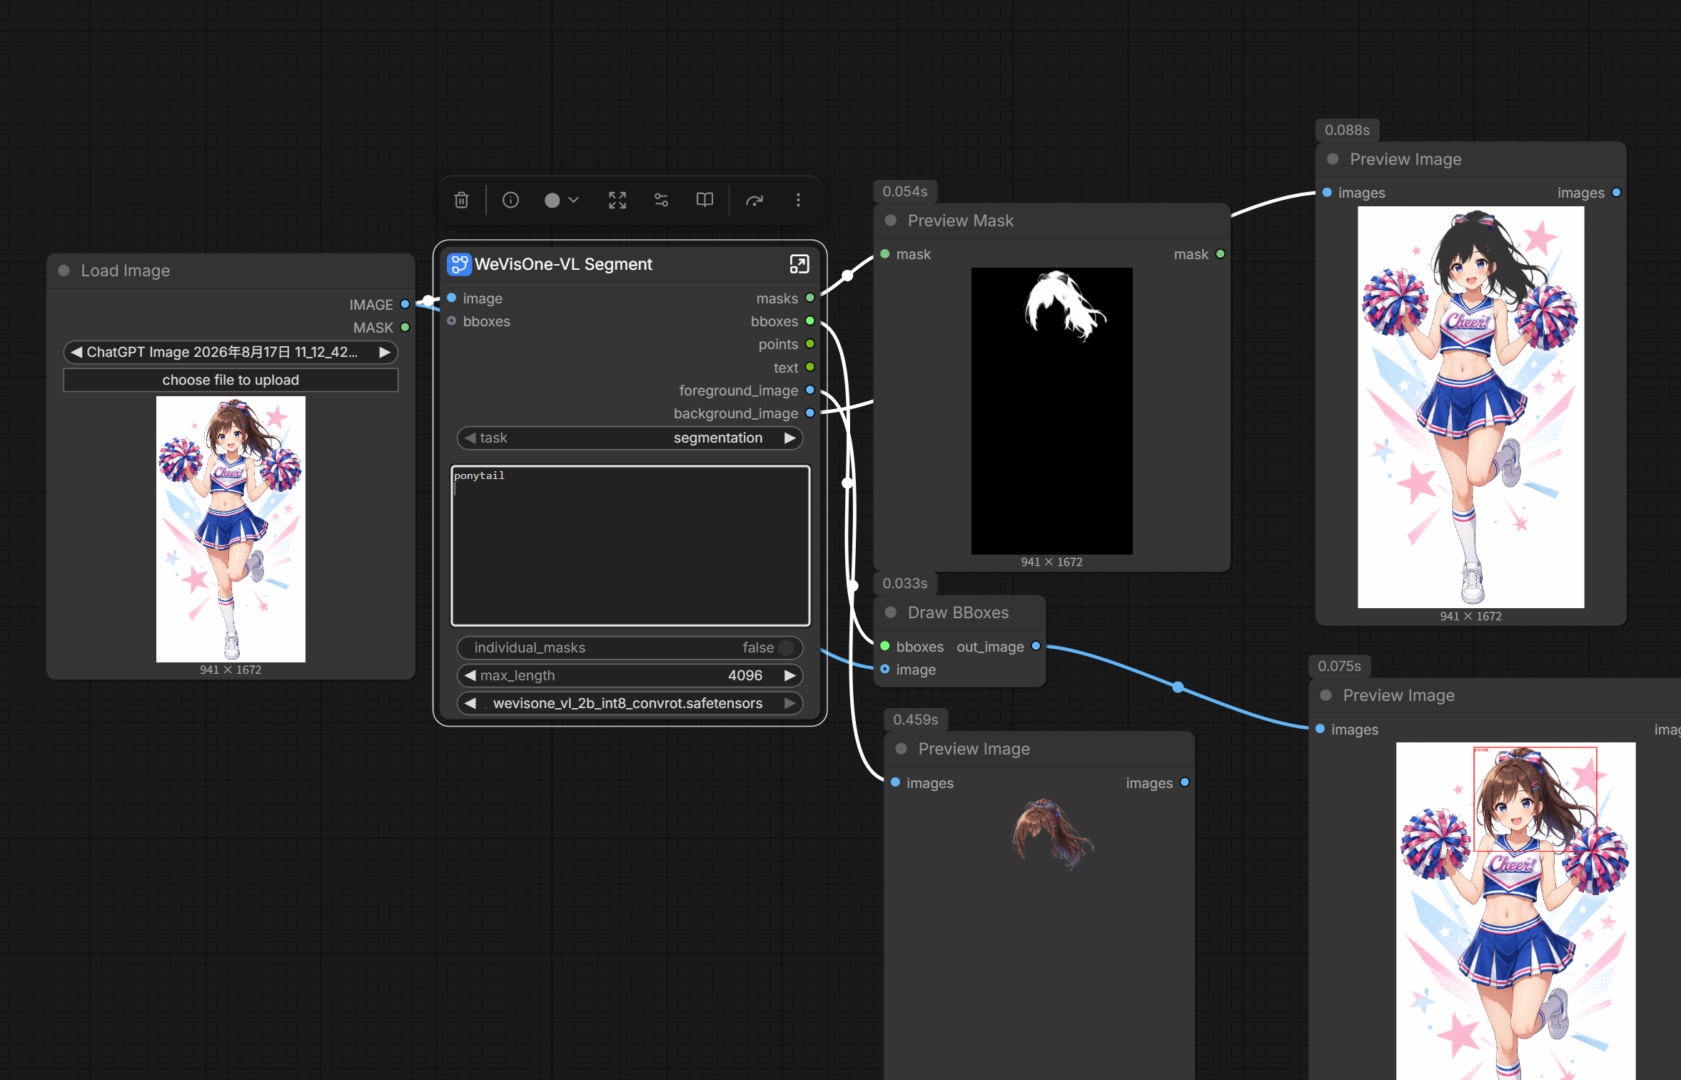
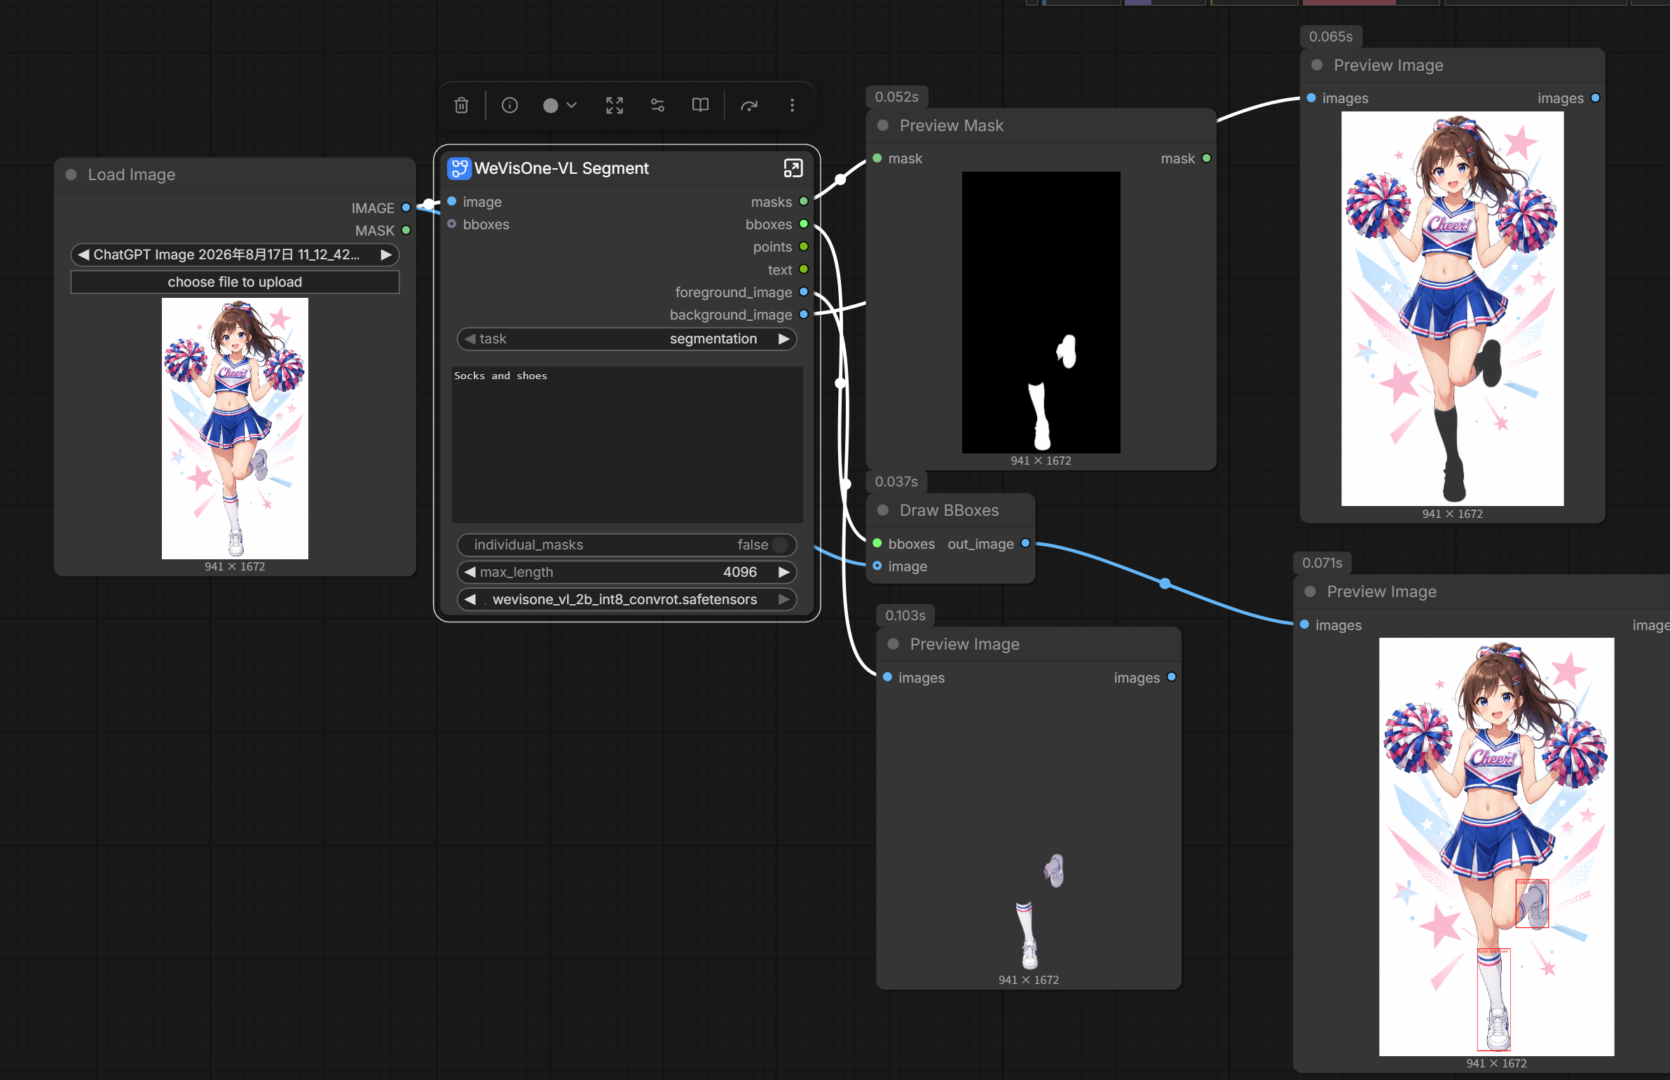
デフォルトのsegmentationで実行すると、masks、foreground_image、background_image、bboxesの4種類出力できます。
RTX4060Ti(VRAM 16GB/RAM 64GB)で約3秒でした。
二次元画像でも問題なく使えます。
まとめ
公式ワークフローだけでもかなり扱いやすいモデルに感じました。
SAM3と似てますが、あっちは独自ライセンスだったり、NSFW系が検出しにくかったりするのに対し、WeVisOne-VLはApache License 2.0でNSFW系も比較的検出しやすい印象です。
まだ試行回数が少ないのでどの程度検出できるか、精度はどうなのかとかはもう少し使ってみないと分かりませんが、特定の領域を加工・修正したりするのに便利だと思います。
追記:画像にもよりますが、いくつか試したら検出できないのがありました。
なのでNSFW系はそこまで強いってわけじゃないのかもしれません。
以上WeVisOne-VLについて紹介しました。
参考になれば幸いです。