今からStable Diffusionで画像生成AIを始めたいという方に向けて、Stable Diffusion Web UI AUTOMATIC1111(以下A1111)の使い方をご紹介します。
A1111(Stable Diffusion WebUI)とは?
A1111は、画像生成AIの「Stable Diffusion」をローカルのパソコンで動かせるWeb UIです。
正式名称はStable Diffusion Web UI(AUTOMATIC1111版)。
Pythonの「gradio」というライブラリで作られていて、ブラウザ上の画面からプロンプトを打つだけで画像を生成できます。
Stable Diffusion自体は2022年に登場した「テキストから画像を作る」モデルですが、それ単体だと扱いづらいので、こういうWeb UIを被せて使うのが一般的です。
派生UIにはForge、ComfyUI、Fooocus、SwarmUIなどがありますが、A1111はその中でもおそらく一番最初に公開された定番ツールです。
拡張機能を入れれば、生成の効率化や自分好みのカスタマイズもできます。

2026年のA1111と「Forge」について
A1111本体(AUTOMATIC1111)の更新は、現在止まっています。(26年6月時点)
その代わりとしてSDWebUI Forgeが登場し、その後Forgeがさらに派生してreForge、Forge classic/NeoなどのWeb UIが開発されてきました。
これらはA1111とほぼ同じ操作感のまま、生成速度の向上や新しいモデルなどに対応しています。
なのでWebUI入門としてA1111から始めるのは全然ありですが、新モデルや最新技術を使いたい場合は、最初からForge系で始めるか、慣れてから移行するのをお勧めします。
多少の違いはあるものの、画面や基本操作はA1111とほぼ共通なので、途中で移行してもそのまま操作できると思います。
A1111のインストール方法
インストール方法は2通りありますが、本記事ではgitとpythonを使う「手動インストール」で進めます。
出回っている解説のほとんどがこの方法なので、詰まったときも情報を探しやすいためです。
git・pythonでインストール
先にGitとPythonを入れてから、A1111をクローンします。
・Git for Windows
Gitはコードの変更履歴などを保存できる分散型バージョン管理システムです。
インストールすることでGitHubとのやり取りもスムーズになります。
- 公式サイトにアクセス
- インストーラを「Download」
- 実行してすべてデフォルトのままNext連打
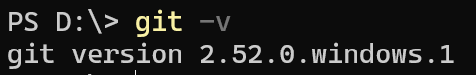
ターミナルやcmdで git -v でバージョンが表示されればインストールは完了です。
・Python 3.10.6
pythonはプログラミング言語の一つです。
このSDWebUIはほぼpythonで作られているため、動かすためにインストールが必要です。
- 公式サイトに移動
- 「Windows installer (64-bit)」をダウンロード
- 「Add Python to PATH」にチェックを入れる
- 「Install Now」で進める
・A1111のクローンと起動
GitHubからA1111をクローンします。任意のパスで以下を実行してください。
git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui.gitstable-diffusion-webuiフォルダの中のwebui-user.batを実行すると、必要なものが自動でインストールされ、終わるとWebUIが開きます。
ただし、現在更新されてないため、一部自身で修正が必要です。
エラーで起動出来ない場合の対処法
2026年6月時点で、2つのエラーで起動ができなくなっています。
「No module named ‘pkg_resources’」が出る場合(CLIPのインストール失敗)
1つはNo module named ‘pkg_resources’というエラー。
これは古いCLIPのビルド処理に、隔離ビルドが「新しすぎるsetuptools」を持ち込んで衝突しているそうです。
なのでsetuptools・wheelのバージョンを指定してインストール、そのあとCLIPをインストールすれば起動できます。
stable-diffusion-webui のフォルダでpowershellを開き、以下を順に実行してください。
.\venv\Scripts\python.exe -m pip install --force-reinstall setuptools==69.5.1 wheel==0.45.1
.\venv\Scripts\python.exe -m pip install --no-build-isolation "https://github.com/openai/CLIP/archive/d50d76daa670286dd6cacf3bcd80b5e4823fc8e1.zip"
「Couldn’t clone Stable Diffusion」/ error code 128 が出る場合(配布元が消えている)
もう1つは、配布元が消えているものをインストールしようとするため、そのせいで起動できない状態になっているもの。
コンソールには以下のように表示されます。
RuntimeError: Couldn't clone Stable Diffusion.
remote: Repository not found.
fatal: repository 'https://github.com/Stability-AI/stablediffusion.git/' not found
Error code: 128
なので自分で指定が必要です。
webui-user.batをメモ帳などで開いて以下を追加してください。
set STABLE_DIFFUSION_REPO=https://github.com/w-e-w/stablediffusion.git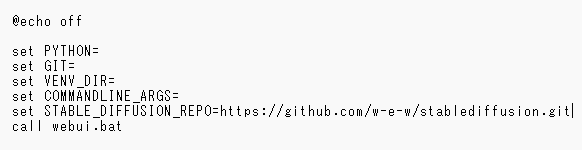
保存したあと、webui-user.batを実行すればA1111を開けるようになります。
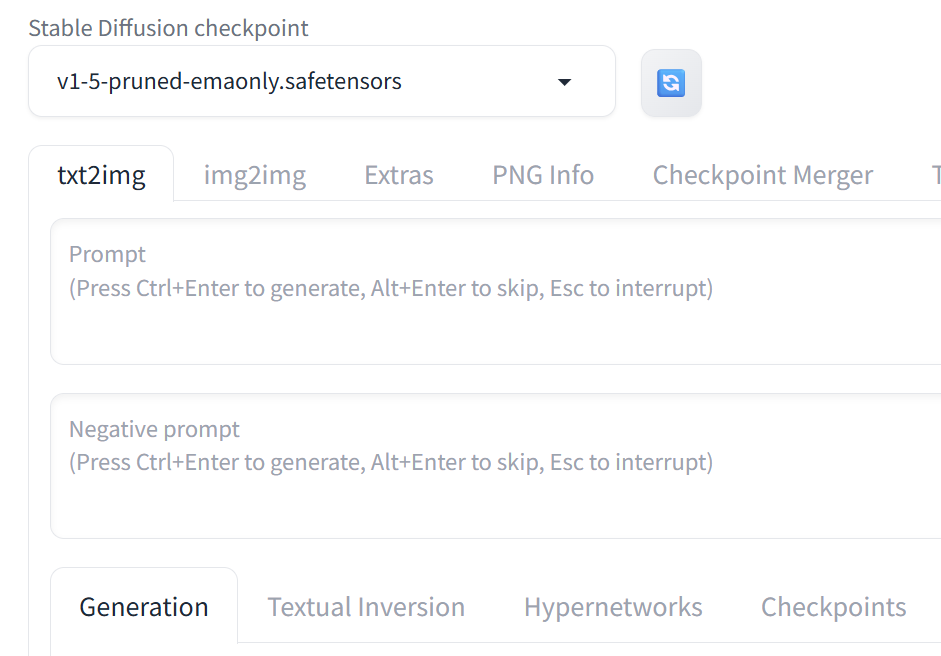
ブラウザでこんな画面が開けばインストール完了です。
パッケージ版(簡単に試したい人向け)
GitやPythonを用意せず、ワンクリックで使えるパッケージ版(sd.webui.zip)もあります。
下のページからzipを落として解凍し、update.bat→run.batの順に実行すれば動きます(日本語を含まないパスに置くのが無難です)。

ただしパッケージ版はモデルを置くパスなどフォルダ構成が手動版と違い、出回っている解説も少なめです。
なので基本はGit・pythonを使ったインストールを推奨します。
A1111の基本的な使い方
とりあえず画像生成してみる
起動するとこんな画面が表示されます。
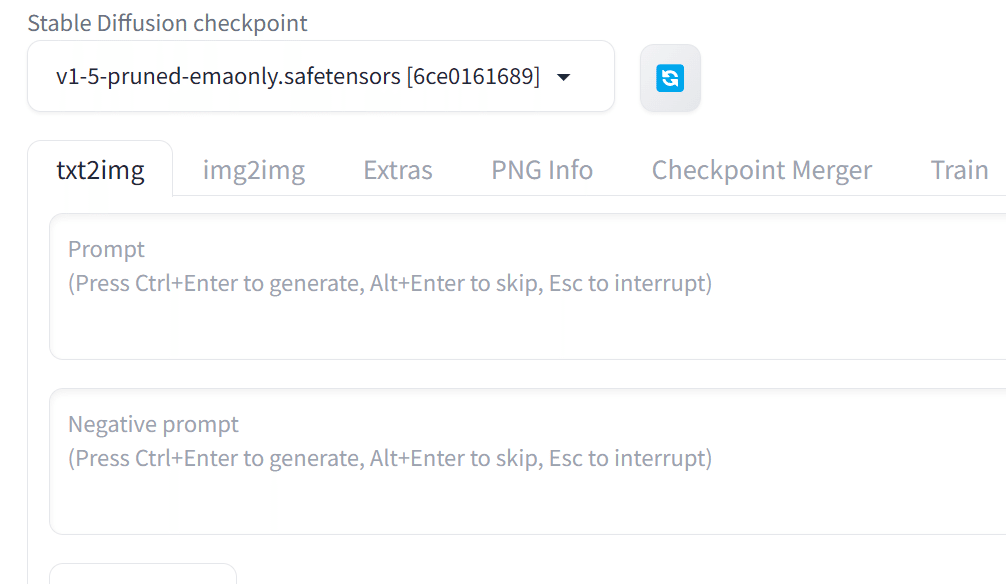
画面上部の「Stable Diffusion checkpoint」は、画像生成に使うモデルを選択する欄です。
使用モデルによって生成できる画像の種類やテイストが異なります。
モデルが入っていない状態で通常の初回起動をすると、SD1.5のv1-5-pruned-emaonly.safetensorsが自動でダウンロードされます。
まずはこのモデルを選び、読み込みが終わってから画像を生成してください。
その下の入力欄はどんな画像を生成するかテキストで指示するものです。
基本は英単語をカンマで区切り、上のpromptには生成したいもの、下のnegative promptには生成したくないものを入力します。
prompt:fish, in the sea, fantastic
negative prompt:low quality, normal quality, worst quality
negative promptに入れているのは、低クオリティの画像を避けるためのものです。
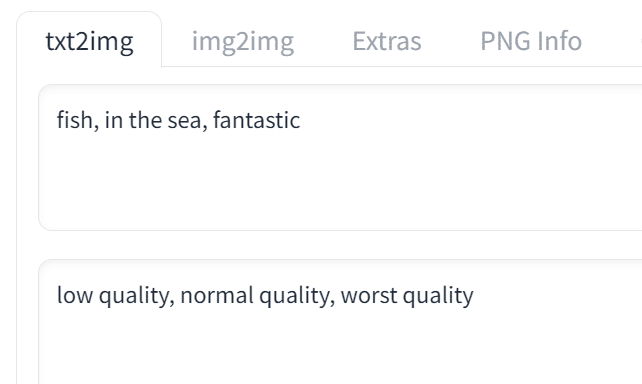
入力し終わったら、Generateボタンで画像生成の処理が始まります。
・生成した画像
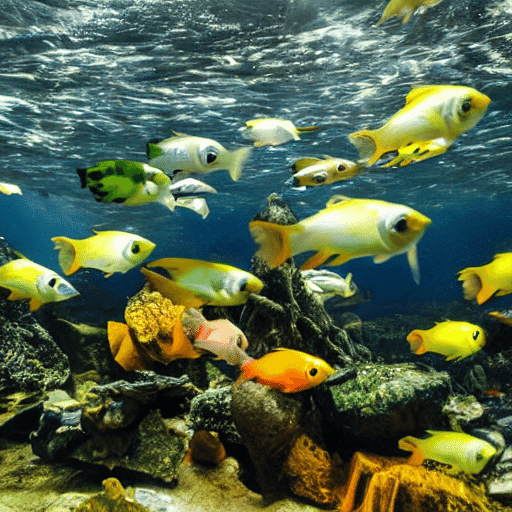
生成した画像は以下のパスに保存されます。
stable-diffusion-webui\outputプロンプトの基礎
プロンプトでは括弧や値を使うことで、要素の強弱やステップ数を指定することができます。
・丸括弧
赤という色を強調したい場合、(red)のように丸括弧で囲むとより強く反映させることができます。
括弧を増やすと効果が強くなります。
例)((((red))))
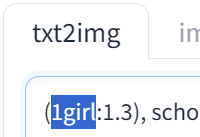
倍率を数値で指定することも可能です。
例)(red:1.2)
手入力ではなく、プロンプトを選択してCtrl+上下キーで値の増減も可能です。
・角括弧
丸括弧と逆で特定の要素を弱めることができます。
[red]
[[[[red]]]]
[red:1.2]
・プロンプトの切り替え
これは生成STEP中に使用するプロンプトを切り替えられるものです。
Stable Diffusionは徐々にノイズを取り除いて画像を生成し、Sampling Stepsがそれを何回行うかというパラメータです。
例えば20なら20回の工程を経て画像が生成されます。
[red:black:10]のように入力すると、STEP10まではred、STEP11からはblackを使うという切り替えが可能です。
・AND
大文字のANDを使うと二つの要素を融合させることができます。
例えば「apple AND chair」と入力すると、りんごと椅子を融合したような画像が生成できます。
・BREAK
BREAKはプロンプトを区切って、他の要素と干渉させにくくするものです。
例えば髪色をblack hair、服の色をred clothesのようにした場合、お互いの色が混ざってしまう場合があります。
これを防ぐために「black hair, BREAK red clothes」のようにすることで、色の干渉を防ぐ効果が得られます。
なお、プロンプトは75トークンで1つのチャンクとしてカウントされます。
1トークンはプロンプト1つのことで、チャンクはプロンプトを分割して処理できる単位です。
75トークン以上になると自動的にチャンクが2つに分かれます。
プロンプト入力欄の右上を見ると、75を超えたタイミングで分母が増えているのがわかると思います。
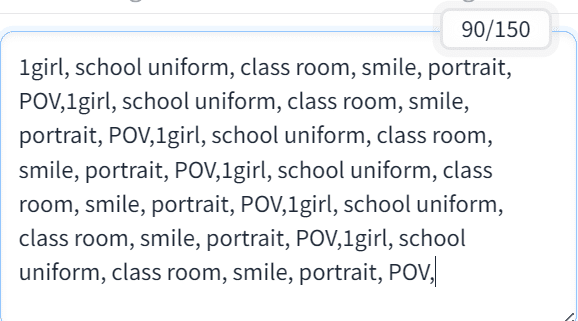
このチャンクを任意の場所で分割できるのがBREAKです。
75トークンに届いていなくても、BREAKを使うとその時点で分母が増え、チャンクが2つになります。
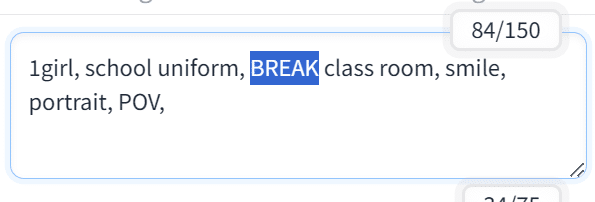
SD1.5モデルだと特定のカテゴリのプロンプトを1つのチャンクに入れて、分割する方が多いようです。
例)人物像, BREAK 服装, BREAK ポーズ, BREAK 背景・シチュエーション
新しいモデルはBREAKなしでも比較的Promptがしっかり反映されるため、モデルに応じて使い分けてください。
各パラメータの意味
txt2imgで設定できるパラメータについて解説します。
・Sampling method
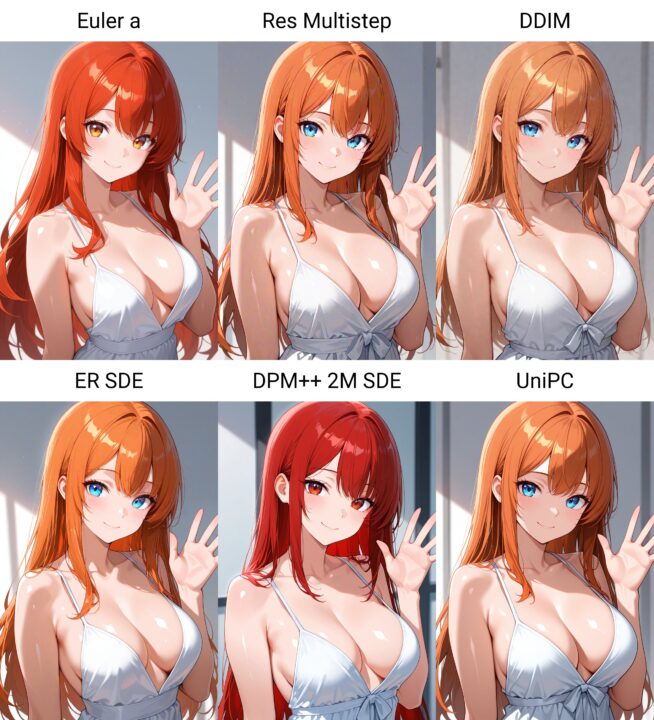
Sampling methodは、ノイズを除去するアルゴリズムを選べるものです。
使用するSamplingによって少し画像のテイストなどが変わります。
・Sampling steps
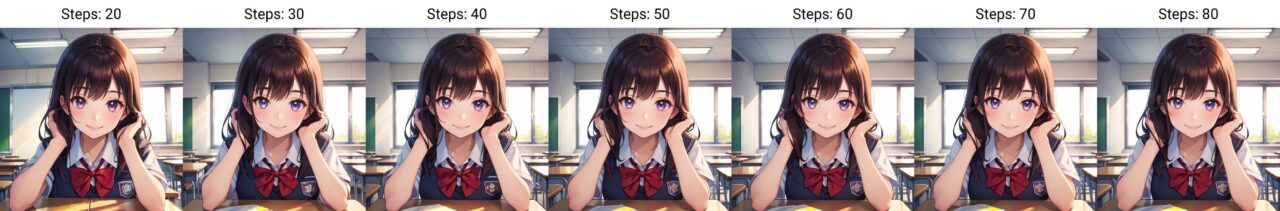
Sampling stepsは、ノイズを除去する工程を何STEPで行うかです。
STEP数が多いと高クオリティで鮮明な画像になると言われていますが、その分処理が長くなります。
モデルによって適切な値も違うので、モデルデータの詳細などがあればそちらを参照してください。
SD1.5、SDXL辺りであれば基本20~30で使う方が多いと思います。
・Hires. fix
Hires. fixは高画質化処理ができる機能です。
チェックを入れて生成すると、画像を高画質化できます。
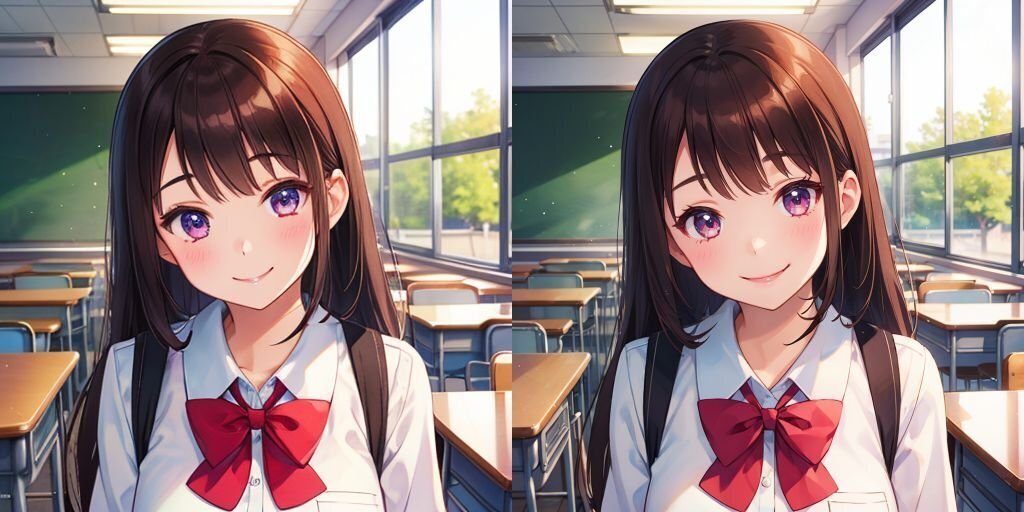
またUpscalerの種類や倍率、Denoising strengthによってクオリティも変化します。
Upscalerは好みのもので良いです。
倍率はモデルにもよりますが大体1.5~2倍、Denoising strengthは0.4~0.6辺りで調整している方が多い印象です。
左:Hires. fixなし
右:Hires. fixあり
・Width・Height:Widthは画像の横幅、Heightは画像の縦幅です。
・Batch count:生成する画像枚数を指定できます。2の場合、1枚ずつ処理して2枚生成します。
・Batch size:一度に生成する画像枚数を指定できます。2の場合、一度の処理で2枚生成します。
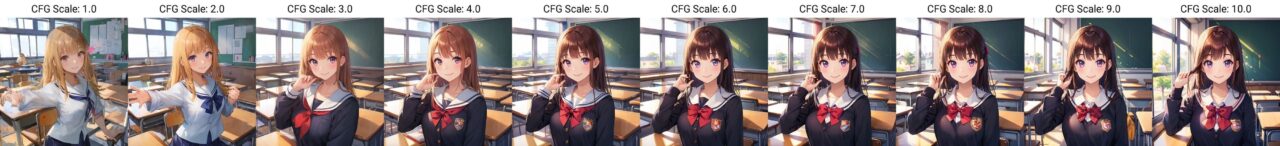
・CFG Scale:生成される画像がプロンプトにどの程度従うかを制御できます。
使用プロンプト:1girl, school uniform, class room, smile, portrait, POV
・Seed:シード値はランダム性を制御するものです。
デフォルトの-1だと生成するごとにランダムの値が付き、それぞれ異なる画像が生成されます。
付与されたシード値を使って生成すると同じ画像を生成できます。
過去に生成した画像や、ネット上でメタデータが公開されている画像を再現するときに便利です。
追加モデルの入れ方
好みのcheckpoint・VAE・LoRA・Embeddingを追加する場合は、使うモデルに対応したファイルを用意してください。
Civitai・Hugging Faceでの探し方とダウンロード方法は、以下の記事にまとめています。
ダウンロード後は、ファイルの種類ごとに配置先が異なります。
手動インストール版はstable-diffusion-webui、パッケージ版はsd.webui\webuiを開き、次のフォルダへ入れてください。
| 種類 | 開いたフォルダからの配置先 | 用途 |
|---|---|---|
| checkpoint | models\Stable-diffusion | 画像生成の本体となるモデル |
| VAE | models\VAE | 潜在表現を画像へ変換 |
| LoRA | models\Lora | 画風・キャラクターなどの特徴を追加 |
| Embedding(Textual Inversion) | embeddings | 学習した特徴をプロンプトから呼び出す |
インストール方法ごとの配置先は以下の通りです。
# 手動インストール版
stable-diffusion-webui\models\Stable-diffusion
stable-diffusion-webui\models\VAE
stable-diffusion-webui\models\Lora
stable-diffusion-webui\embeddings

# パッケージ版
sd.webui\webui\models\Stable-diffusion
sd.webui\webui\models\VAE
sd.webui\webui\models\Lora
sd.webui\webui\embeddings
checkpointを選択する
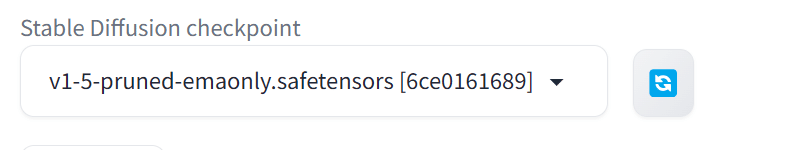
ファイルを配置したら、画面上部の「Stable Diffusion checkpoint」の横にある更新ボタンを押してください。
プルダウンに追加したモデルが表示されるので、選択して読み込みが終わるのを待ちます。
一覧に出ない場合は、配置先を確認してからA1111を再起動してください。
VAEを選択する
VAEはcheckpointに組み込まれている場合もあるので、外部VAEを使うかどうかはモデルの配布ページで確認してください。
外部VAEを配置したら、「Settings」の検索欄で「Quicksettings」を検索し、「Quicksettings list」にsd_vaeを追加します。
「Apply settings」→「Reload UI」の順に押してください。
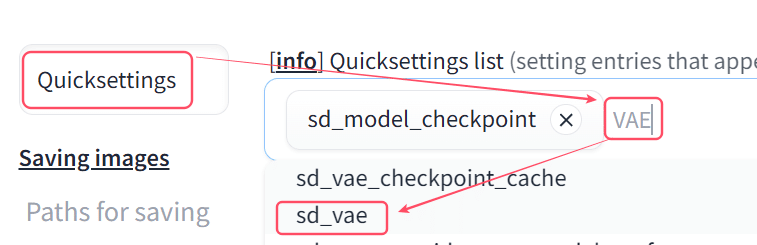
画面上部にVAEの選択欄が表示されるので、配置したファイルを選んでから画像を生成します。
「Automatic」は画質を比較して最適なVAEを選ぶ設定ではないので、使用するVAEが決まっている場合はファイル名を指定してください。
LoRAを適用する
LoRAを配置したら、「Lora」タブで一覧を更新するか、A1111を再起動してください。
追加したLoRAのカードをクリックすると、通常のプロンプト欄へ呼び出し文字列が入ります。
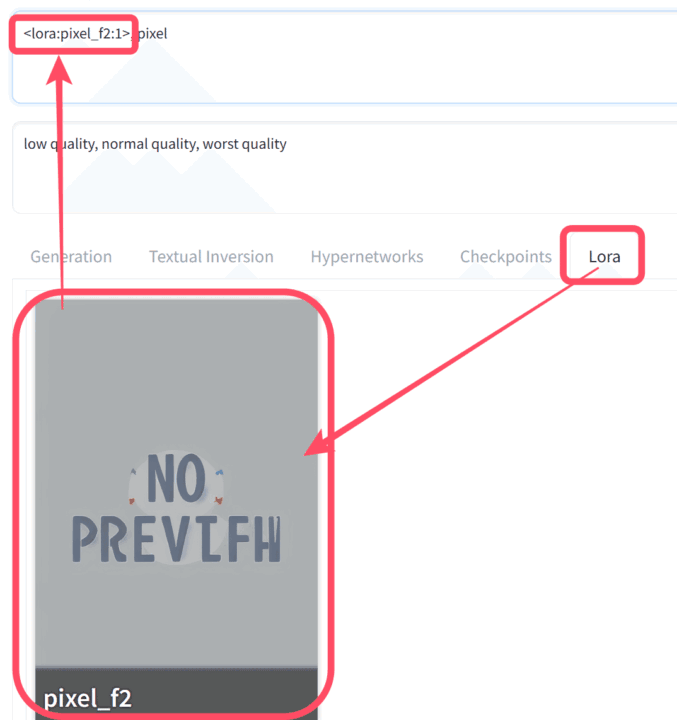
例えば、pixel_f2という名前のLoRAを使う場合は次の形式です。
<lora:pixel_f2:1>, pixelpixel_f2は拡張子を除いたファイル名で、末尾の1で適用する強さを指定します。
実際には、自分が追加したLoRAの名前を使ってください。
配布ページにトリガーワードがある場合は、この例のpixelのようにプロンプトへ追加します。
必要なトリガーワードはLoRAごとに異なり、不要なものもあります。
入力後は「Generate」で画像を生成し、反映が強すぎる場合は次のように数値を下げて調整してください。
<lora:pixel_f2:0.7>Embedding(Textual Inversion)を適用する
Embeddingを配置したら、「Textual Inversion」タブの一覧を更新するか、A1111を再起動してください。
入力先のプロンプト欄を選択してからカードをクリックすると、呼び出し名が入力されます。
ネガティブプロンプト用のデータなら、先にネガティブプロンプト欄を選択してください。
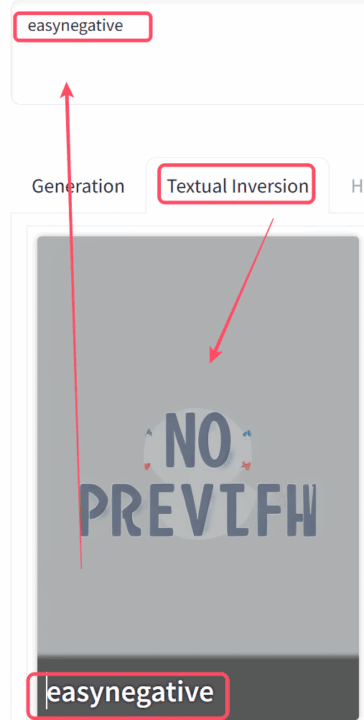
画像はEasyNegativeを追加した例です。
EmbeddingはLoRAの<lora:名前:強さ>とは異なり、呼び出し名をプロンプトへ入れて使います。
入力後は「Generate」で画像を生成してください。
意図した要素まで出にくくなった場合は、一度呼び出し名をプロンプトから外して結果を確認できます。
拡張機能の入れ方
拡張機能を追加すると、日本語表示やプロンプト入力の補助など、A1111で使える機能を増やせます。
インストール方法は、A1111内の一覧から選ぶ方法と、GitHubのURLを指定する方法の2通りです。
一覧からインストールする
「Extensions」→「Available」を開き、「Load from:」ボタンを押すと一覧が表示されます。
追加したい拡張機能の「Install」を押し、完了後は「Installed」タブで「Apply and restart UI」をクリックしてください。
再読み込み後に、拡張機能のタブや設定項目が追加されます。
GitHubのURLからインストールする
拡張機能の配布元で、GitHubリポジトリのURLをコピーしてください。
「Extensions」→「Install from URL」を開き、「URL for extension’s git repository」に貼り付けて「Install」を押します。
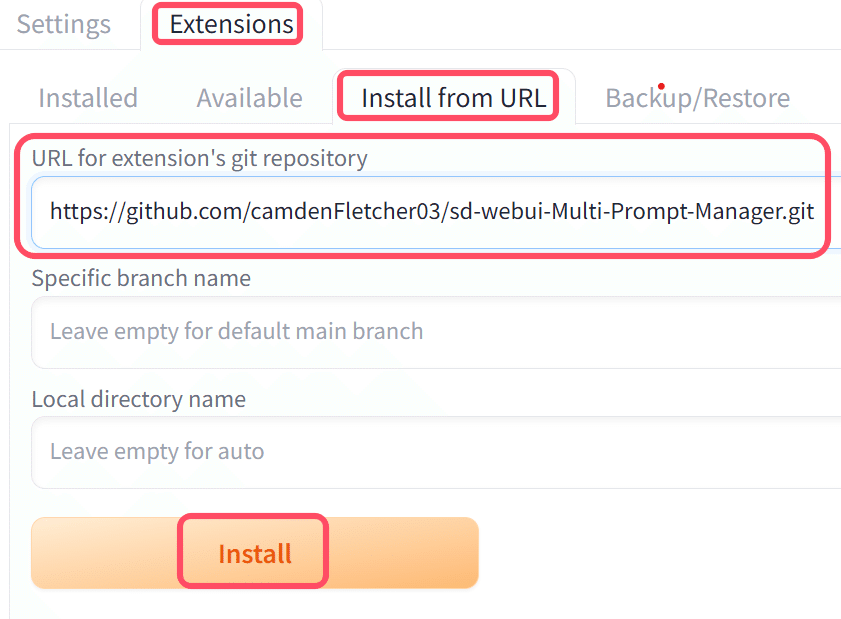
インストール後は、「Installed」タブで「Apply and restart UI」をクリックしてください。
UIの再読み込みだけで反映されない場合は、A1111を終了してから起動し直します。
基本操作を便利にする設定
Clip skipを画面上部に表示する
Clip skipは、プロンプトを処理するCLIPのどの段階の出力を使うかに関わる設定です。
モデルの配布ページで値が指定されている場合に変更しやすいよう、画面上部へ表示できます。
「Settings」で「Quicksettings」を検索し、「Quicksettings list」にCLIP_stop_at_last_layersを追加してください。
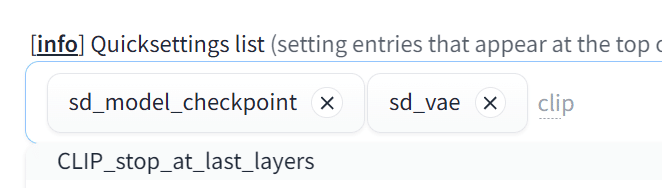
「Apply settings」→「Reload UI」の順に押すと、画面上部でClip skipの値を変更できます。
値は一律に決めず、使うモデルの配布ページに指定があれば合わせてください。
Styleでプロンプトを保存する
Styleは、よく使うプロンプトとネガティブプロンプトに名前を付けて保存する機能です。
同じ文章を繰り返し入力する手間を減らせます。
「Generate」ボタンの下にあるペンのアイコンから、Styleの編集画面を開いてください。
保存するプロンプトとネガティブプロンプトを入力し、名前を付けて「Save」を押します。
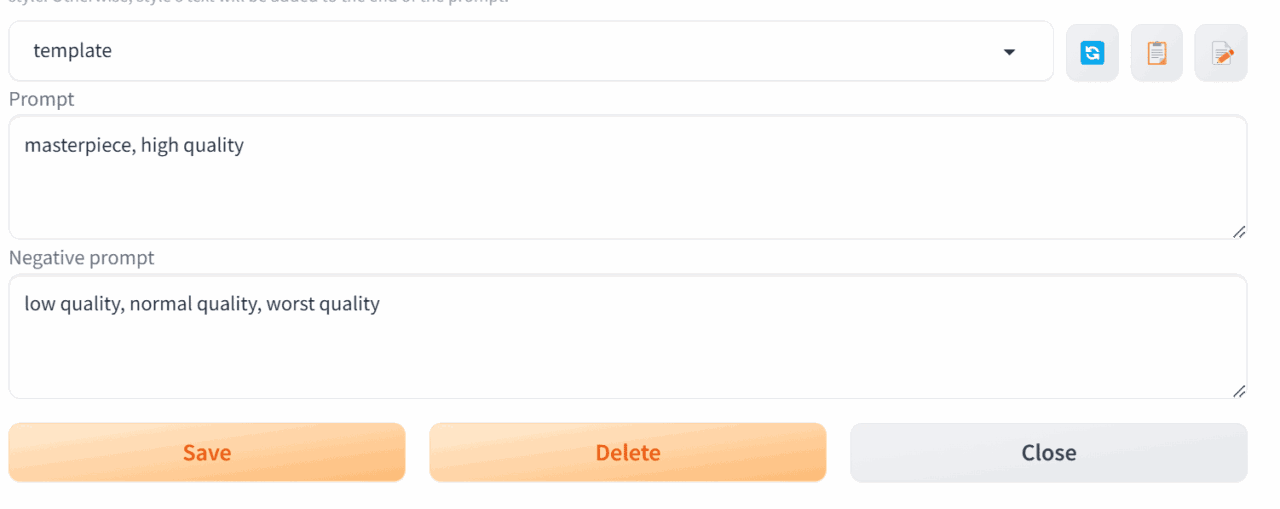
編集画面を閉じると、Styleの選択欄に保存した名前が表示されます。
そのStyleを選んだ状態で生成すると、保存したプロンプトが適用される仕組みです。
入力欄へ呼び出して編集したい場合は、Styleを選んでからクリップボードのアイコンをクリックしてください。
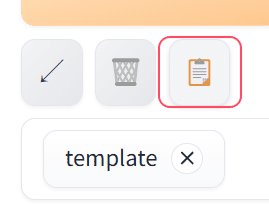
保存内容を削除する場合は、編集画面で対象のStyleを選んで「Delete」を押します。
起動オプションを設定する
手動インストール版では、webui-user.batに起動オプションを記入できます。
メモ帳などで開き、set COMMANDLINE_ARGS=の行へ追加してください。
例えば、画面をダークテーマにする場合は次のように記入します。
set COMMANDLINE_ARGS=--theme dark複数のオプションは半角スペースで区切り、保存後にA1111を起動し直してください。
利用できる項目は、公式の起動オプション一覧で確認できます。
A1111を更新する
パッケージ版は、A1111を終了してからupdate.batを実行すると更新できます。
手動インストール版は、stable-diffusion-webuiフォルダでターミナルを開き、次のコマンドを実行してください。
git pull配布元に新しい変更があれば取得されるので、終了後にwebui-user.batで起動し直します。
まとめ
とりあえず基本的なtxt2imgはこの記事の操作でできると思います。
細かい機能を含めるともっといろいろあるので、それは順次追加するか、長くなりそうな場合は別記事でまとめてます。
以上A1111の基本的な使い方を紹介しました。
参考になれば幸いです。